# WikiZEIT
> WikiZeit: Projekt edukacyjny o Wikipedii i etycznym SEO Jakuba T. Jankiewicza. Poznaj mechanizmy największej encyklopedii świata i zadbaj o widoczność swojej marki.
WikiZEIT to edukacyjny projekt poswiecony Wikipedii i etycznemu SEO,
prowadzony przez Jakuba T. Jankiewicza. Strona zawiera blog z artykułami
o Wikipedii, Wikidanych, danych strukturalnych Schema.org i pozycjonowaniu.
Projekt promuje najlepsze praktyki edycji Wikipedii oraz etyczne podejscie
do SEO i budowania widocznosci marek w wyszukiwarkach.
- Strona: https://wikizeit.edu.pl
- Email: jakub@wikizeit.edu.pl
- Jezyk: polski
## Blog
### Gdzie czytać o Wikipedii? Przegląd blogów i serwisów.
Gdy myślimy o Wikipedii, najczęściej widzimy suchą, encyklopedyczną treść. Rzadko jednak
zastanawiamy się, co dzieje się za jej kulisami. Kto decyduje o usuwaniu haseł? Jak organizowane są
akcje edycyjne? Gdzie toczy się dyskusja o płatnych edycjach (Conflict of Interest) i etycznym
obecności marek w encyklopedii?
Aby zrozumieć ten świat, warto wyjść poza samą domenę wikipedia.org. Przedstawiamy zestawienie
najważniejszych blogów i serwisów, które regularnie i rzetelnie analizują mechanizmy rządzące
największą encyklopedią świata.
## Oficjalne serwisy ruchu Wikimedia
To tutaj bije serce społeczności i to stąd pochodzą najbardziej wiarygodne ogłoszenia oraz
podsumowania działań projektów partnerskich.
* **[Diff (W movement news)](https://diff.wikimedia.org/)**: Globalny, oficjalny blog ruchu
Wikimedia. To wielojęzyczna platforma, na której wikipedyści z całego świata dzielą się swoimi
doświadczeniami, technicznymi nowinkami oraz analizami dotyczącymi wolnej wiedzy.
* **[Blog Wikimedia Polska](https://wikimedia.pl/blog/)**: Obowiązkowa lektura na rodzimym
podwórku. Polski oddział stowarzyszenia regularnie publikuje tu informacje o konkursach (takich
jak Wiki Lubi Zabytki), szkoleniach dla instytucji kultury oraz projektach edukacyjnych
realizowanych na uczelniach.
## Niezależne projekty i perspektywa ekspercka
Poza oficjalnymi kanałami fundacji istnieją miejsca tworzone przez pasjonatów i profesjonalistów, którzy patrzą na Wikipedię pod kątem technologicznym, etycznym lub marketingowym.
* **[WikiZEIT](https:wikizeit.edu.pl)**: Nasz własny projekt edukacyjny. Na łamach WikiZEIT skupiamy
się na demistyfikacji mechanizmów Wikipedii. Analizujemy reguły dotyczące Konfliktu Interesów
(WP:KI), edukujemy rynek w zakresie etycznego SEO oraz pokazujemy, jak poprawnie (i zgodnie z
zasadami społeczności) współpracować z encyklopedią bez narażania się na blokady.
* **[The Signpost](https://signpost.news/)**: Choć technicznie jest to wewnętrzna, anglojęzyczna
gazeta społeczności angielskiej Wikipedii, w praktyce działa jak profesjonalny, niezależny portal
dziennikarski. Od lat publikuje dogłębne śledztwa, analizuje globalne trendy, zmiany w
oprogramowaniu MediaWiki oraz wielkie debaty dotyczące wolności słowa w sieci.
* **[Planeta Wikimedia (Archiwum)](https://pl.planet.wikimedia.org/)**: Choć projekt ma dziś
charakter w dużej mierze historyczny, warto o nim wspomnieć. Był to agregator blogów tworzonych
przez samych wikipedystów, stanowiący świetną kronikę tego, jak polska społeczność kształtowała
się przez lata.
## Nurt krytyczny, demaskatorski i fact-checkingowy
Wikipedia, mimo swoich szczytnych założeń, to także skomplikowana struktura władzy, mechanizmów
społecznych oraz podatności na manipulacje. Jeśli chcesz poznać drugą, znacznie mniej uładzoną
stronę medalu, warto zajrzeć do miejsc, które zajmują się wyłącznie punktowaniem błędów i analizą
zakulisowych konfliktów.
* **[WikiKrytyk](https://wikikrytyk.wordpress.com/)**: Był to polski odpowiednik globalnych ruchów
demaskatorskich. Blog skupiał się na personalnych i systemowych rozliczeniach wewnątrz polskiej
społeczności. Znajdziesz tu analizy kontrowersyjnych decyzji administratorów, opisy lokalnych
"wojen edycyjnych" oraz krytykę procedur, które autorzy bloga uznawali za nietransparentne dla
nowych użytkowników.
* **[Wikipediocracy](https://wikipediocracy.com/)**: To najbardziej znany anglojęzyczny, niezależny
portal i forum dyskusyjne, które bezlitośnie prześwietla fundamenty Wikimedia Foundation. Serwis
słynie z tropienia ukrytych konfliktów interesów, demaskowania fałszywych tożsamości adminów oraz
analizowania, jak grupy nacisku manipulują treściami w angielskiej Wikipedii. Z chwilą pisania
tego wpisu strona była niedostępna tutaj [kopia w
archive.org](https://web.archive.org/web/20260729115502/https://wikipediocracy.com/).
* **[Portal Demagog](https://demagog.org.pl/)**: Chociaż to czołowy polski serwis fact-checkingowy,
a nie blog o Wikipedii, regularnie publikuje bardzo mocne analizy dotyczące podatności
encyklopedii na dezinformację. Demagog punktuje m.in. to, jak na Wikipedii latami potrafią
utrzymać się fikcyjne biografie czy jak wojny geopolityczne wpływają na treść artykułów.
## Dlaczego warto śledzić te źródła?
Większość kryzysów wizerunkowych firm w Wikipedii wynika z niewiedzy. Agencje SEO i PR często
próbują traktować encyklopedię jak darmowy katalog linków lub przestrzeń reklamową. Regularne
czytanie branżowych blogów – zarówno tych oficjalnych, jak i niezależnych – pozwala zrozumieć, że
Wikipedia to przede wszystkim dynamiczna społeczność rządząca się rygorystycznymi zasadami
weryfikowalności i neutralnego punktu widzenia.
Zrozumienie tych mechanizmów to jedyna droga do prowadzenia czystego, etycznego i skutecznego
dialogu z twórcami wolnej wiedzy.
---
### Piotr Konieczny z Niebezpiecznika miał zostać skasowany
Jestem autorem artykułu w Wikipedii o [Piotrze
Koniecznym](https://pl.wikipedia.org/wiki/Piotr_Konieczny_(informatyk)), założycielu
[Niebezpiecznika](https://pl.wikipedia.org/wiki/Niebezpiecznik.pl), portalu o
cyberbezpieczeństwie. Artykuł o Piotrze Koniecznym powstał w styczniu 2020 roku.
W maju 2021 został zgłoszony do usunięcia przez jednego z Wikipedystów. Co ciekawe o takim samym
imieniu i nazwisku. W Wikipedii każdy może zgłosić artykuł do usunięcia, czyli do
[DNU](https://pl.wikipedia.org/wiki/Wikipedia:Poczekalnia) (dyskusja nad usunięciem). Oficjalna
nazwa to poczekalnia.
Argumentem za rozpoczęciem dyskusji, tak samo, jak w przypadku strony Niebezpiecznik.pl w Wikipedii:
Niszowy portal o cyberbezpieczeństwie, mimo że to leader tej niszy. A założyciel portalu jest bardzo
znany i często pojawia się w mediach, głównie jako expert omawiający zagadnienia związane z
cyberbezpieczeństwem.
Argumentem za zostawieniem natomiast było założenie Niebezpiecznika oraz
nagroda [Digital Shapers](https://pl.wikipedia.org/wiki/Digital_Shapers).
Aby „podnieść” rangę nagrodzie, dodałem stronę nagrody do Wikipedii.
Wypowiedziało się także kilka innych Wikipedystów, wskazując np.:
> Jeden z najważniejszych polskich ekspertów w dziedzinie cyberbezpieczeństwa.
Efekt Piotr Konieczny nie został skasowany. Status brak konsensusu. Jest to jedna z zasad w
Wikipedii, aby usunąć artykuł, musi być zgodność opinii. Jeśli są osoby które, uznają artykuł za
encyklopedyczny oraz podadzą dobre argumenty. Artykuł zostaje, ze statusem brak jednomyślności.
Całą dyskusję można znaleźć w
[poczekalni](https://pl.wikipedia.org/wiki/Wikipedia:Poczekalnia/biografie/2021:04:26:Piotr_Konieczny). Link
można także znaleźć na stronie dyskusji.
---
### Biblioteka Wikipedii, skąd brać źródła?
Czy kiedykolwiek edytując Wikipedię, chciałeś znaleźć jakiś artykuł, ale okazało się, że dostęp jest
za [paywallem](https://pl.wikipedia.org/wiki/Paywall)? Właśnie w tym pomaga biblioteka Wikipedii.
## Co to jest Biblioteka Wikipedii?
Biblioteka Wikipedii (ang. *The Wikipedia Library*) to projekt Wikimedia Foundation, którego celem
jest dostarczenie źródeł dla aktywnych Wikipedystów. Po dołączeniu do projektu, Wikipedyści dostaja
dostęp do zamkniętych, baz artykułów naukowych i czasopism. Takich jak: SpringerLink, Elsevier,
JSTOR, Nature, Cambridge University Press, Oxford University Press, czy The ACM Digital Library.
O projekcie można przeczytać na stronie
[Wikimedia Foundation](https://wikimediafoundation.org/the-wikipedia-library/) oraz na
[Polskiej Wikipedii](https://pl.wikipedia.org/wiki/Wikipedia:Biblioteka_Wikipedia).
## Jak uzyskać dostęp do Biblioteki Wikipedii?
Aby uzyskać dostęp, wystarczy wejść na [stronę
projektu](https://meta.wikimedia.org/wiki/The_Wikipedia_Library) i zarejestrować się swoim kontem w
Wikipedii (dzięki [OAuth](https://www.mediawiki.org/wiki/Help:OAuth)).
## Jakie są wymagania?
Aby móc skorzystać z biblioteki Wikipedii, musisz spełnić poniższe wymagania:
* **Staż konta**: Minimum 6 miesięcy od momentu rejestracji.
* **Liczba edycji**: Co najmniej 500 nieusuniętych edycji we wszystkich projektach
Wikimedia (np. Wikipedia, Wikimedia Commons).
* **Aktualna aktywność**: Przynajmniej 10 edycji w ciągu ostatnich 30 dni.
* **Brak blokad**: Twoje konto nie może być w danym momencie zablokowane na żadnym z projektów.
## Podsumowanie
Biblioteka Wikipedii to fascynujący, choć mało znany projekt, który daje dostęp do informacji, która
zamknięta jest za paywallami. Daje aktywnym wolontariuszom darmowy dostęp do tysięcy artykułów
naukowych, prestiżowych czasopism i archiwów prasowych.
---
### Jak poprawić widoczność marki osobistej w AI?
Czy Google i AI wie kim jesteś. Gdy wpisujesz swoje imie i nazwisko w Google to czy jesteś
zadowolony z tego co widzisz? Jednak w erze [sztucznej
inteligencji](https://pl.wikipedia.org/wiki/Sztuczna_inteligencja) i [dużych modeli
językowych](https://pl.wikipedia.org/wiki/Duży_model_językowy) (LLM), ludzie zmienili sposób, w jaki
szukają informacji. Google to już niedominujące miejsce wyszukiwania tego, czego potrzebują.
Sposób zapytań także się zmienia, ze słów kluczowych na pełne zdania zazwyczaj w formie pytań.
Tradycyjne [SEO](https://pl.wikipedia.org/wiki/Optymalizacja_dla_wyszukiwarek_internetowych) (Search
Engine Optimization) przeradza się w GEO (Generative Engine Optimization). Dobra wiadomość jest taka,
że możesz przejąć kontrolę nad tym, co sztuczna inteligencja wie na Twój temat. W tym artykule
dowiesz się, jak budować markę osobistą, która będzie widoczna tak robotom, jak i ludziom.
## Budowanie marki eksperta
Pierwszym krokiem, od którego musisz zacząć, jest zbudowanie autorytetu w sieci. Google oraz
algorytmy AI muszą jednoznacznie powiązać Twoje nazwisko z konkretną tematyką. Podstawą jest
regularne i publiczne dzielenie się swoją wiedzą:
* **Prowadzenie bloga tematycznego:** Twoja własna strona to baza, w której szczegółowo opisujesz
branżowe zagadnienia i udowadniasz swoją ekspertyzę.
* **Publikacje gościnne (Guest Posting):** Pisanie artykułów na inne powiązane tematycznie blogi
pozwala Ci dotrzeć do nowej publiczności i zdobyć cenne linki.
* **Występowanie jako autor zewnętrzny i ekspert gościnny:** Publikowanie artykułów eksperckich w
branżowych portalach informacyjnych oraz tradycyjnych czasopismach buduje najwyższy poziom
zaufania algorytmów.
* **Aktywność publicystyczna:** Regularne dostarczanie merytorycznych tekstów i komentarzy
eksperckich do mediów sprawia, że AI zaczyna traktować Cię jako pierwszoplanowe źródło.
### Dlaczego to działa na AI?
Dla modeli językowych (LLM) pojawienie się Twojego imienia i nazwiska w stopce redakcyjnej
renomowanego portalu informacyjnego lub magazynu to bezpośredni sygnał wysokiego **E-E-A-T**. AI ufa
selekcji redaktorów – skoro redakcja dużego portalu dopuściła Twój tekst do publikacji, oznacza to,
że jesteś realnym i wiarygodnym specjalistą.
### Co to jest E-E-A-T?
W AI, jak i w Google liczy się E-E-A-T (Experience, Expertise, Authoritativeness i Trustworthiness).
* **E – Experience (Doświadczenie)**: Wykazanie, że masz praktyczną, życiową styczność z tematem
(np. testowałeś produkt, osobiście przeszedłeś procedurę lub prowadzisz dany biznes).
* **E – Expertise (Ekspertyza)**: Posiadanie formalnej wiedzy, umiejętności lub kwalifikacji w danej
dziedzinie (np. dyplomy, certyfikaty, wykształcenie lub wieloletnia specjalizacja branżowa).
* **A – Authoritativeness (Autorytet)**: Twoja reputacja na zewnątrz – to, jak bardzo jesteś
rozpoznawalny i jak często inni eksperci lub media cytują Cię jako wiarygodne źródło.
* **T – Trustworthiness (Zaufanie)**: Najważniejszy element spajający pozostałe; oznacza
transparentność, uczciwość, bezpieczeństwo strony (np. SSL) oraz dostarczanie sprawdzonych,
prawdziwych informacji.
Budowanie autorytetu poprzez E-E-A-T to process długofalowy. Dlatego warto zacząć już teraz.
### Offline vs Online
Media społecznościowe to świetne narzędzie do bieżącej komunikacji, ale budowanie marki eksperta nie
powinno sprowadzać się tylko do wpisów na LinkedInie, Instagramie czy TikToku. Działając wyłącznie
tam, zostawiasz swoją markę na pastwę kaprysów algorytmów.
Twoje profile społecznościowe powinny być jedynie wsparciem, a nie jedynym filarem obecności w
sieci. Prawdziwą odporność na zmiany algorytmów zyskujesz wtedy, gdy łączysz świat online z
działaniami, które powodują, że ludzie sami będą się tobą interesować.
Najsilniejsze sygnały dla AI i Google powstają często tam, gdzie internet nie sięga bezpośrednio – w
świecie offline oraz w formatach długich (Long-form content):
* **Wystąpienia na konferencjach branżowych:** Prelekcje na żywo sprawiają, że organizatorzy
umieszczają Twoje bio na stronie wydarzenia, a uczestnicy cytują Twoje myśli w swoich relacjach i
postach.
* **Pisanie i wydawanie książek:** Posiadanie własnej książki (lub e-booka) automatycznie podnosi
Twój autorytet, uruchamia proces recenzji, wprowadza Cię do baz takich jak Lubimyczytać czy Google
Books i zmusza innych do powoływania się na Twoje publikacje.
* **Gościnne występy w podcastach i audycjach:** Formaty audio są kopalnią wiedzy dla AI; algorytmy
potrafią transkrybować mowę na tekst, dzięki czemu każda Twoja wypowiedź w cudzym podcaście zasila
ich bazy danych.
* **Współorganizacja i udział w Live’ach:** Transmisje na żywo z innymi twórcami to błyskawiczna
wymiana publiczności i generowanie naturalnych dyskusji oraz komentarzy zawierających Twoje
nazwisko.
* **Członkostwo w stowarzyszeniach i izbach branżowych:** Oficjalna obecność na listach członków
prestiżowych organizacji to dla AI ostateczny dowód na to, że Twoja ekspertyza jest uznawana przez
środowisko.
### Efekt kuli śnieżnej: Jak offline karmi algorytmy AI
Sztuczna inteligencja nie ogląda Twojego wystąpienia na scenie i nie czyta papierowej książki
bezpośrednio z półki. Widzi jednak wpływ, jaki te wydarzenia wywołują w sieci. Kiedy piszesz
książkę lub występujesz na konferencji, inni ludzie zaczynają o Tobie pisać: tworzą recenzje, relacje,
wrzucają zdjęcia z oznaczeniem Twojego profilu i cytują Twoje wnioski. W ten sposób działania
offline generują organiczny, niemożliwy do sfałszowania ślad cyfrowy (digital footprint), który
roboty AI uznają za najbardziej wiarygodne źródło prawdy o Twoim autorytecie.
## Wikipedia: Święty Graal autorytetu
Posiadanie własnego biogramu w Wikipedii to najsilniejszy sygnał zaufania dla AI, jednak wymaga
spełnienia rygorystycznych kryteriów encyklopedyczności i neutralności źródłowej. Dlatego tak ważne
jest zbudowanie widoczności w sieci, zanim nawet pomyśli się o własnym wpisie w Wikipedii.
Dla marek osobistych oznacza to, że musisz wyróżniać się spośród innych podobnych osób. Musisz być
znany, chociaż może to być jakaś wąska dziedzina. Nie musi to być rozpoznawalność, jaką ma
np. Robert Lewandowski czy Donald Tusk.
### Nagrody i wyróżnienia
Ważne są także nagrody i wyróżnienia. Często znaczna nagroda może stać się decydującym argumentem,
gdy ktoś zgłosi twój artykuł do tzw. [Poczekalni, czyli
DNU](https://pl.wikipedia.org/wiki/Wikipedia:Poczekalnia). Poczekalnia to miejsce, gdzie trafiają
artykuły, nad którymi toczy się dyskusja nad usunięciem. Każdy może zgłosić artykuł do usunięcia. W
dyskusji nie liczy się liczba głosów, tylko argumenty oraz
[konsensus](https://pl.wikipedia.org/wiki/Wikipedia:Konsensus). Silny argument, np. znaczna nagroda,
może przeważyć szalę. Jeśli nie ma konsensusu artykuł zostaje w Wikipedii.
Jeśli nagroda jest znaczna, nawet jeśli niszowa, warto także dodać artykuł na temat samej nagrody.
Oczywiscie muszą to być nagrody znaczne, dyplom prezydenta miasta, raczej się nie kwalifikuje.
Warto sprawdzić, czy ktoś, kto nie jest już w Wikipedii, takiej nagrody już nie dostał. Wtedy oprócz
samej nagrody można także dodać kategorię wszystkich osób mających tę nagrodę.
## Wikidane
Dodanie wpisu w [wikidanych](/blog/czym-sa-wikidane.md) to chyba jedna z najważniejszych rzeczy, jaką
możesz zrobić, aby poprawić swoja widoczność w AI.
Wikidane to baza danych w formie [grafu wiedzy](https://pl.wikipedia.org/wiki/Graf_wiedzy). W bazie
tej dodawane są elementy, które mają deklaracje w postaci wartość oraz wartość. Np. jeśli wejdziesz
na wpis w Wikidanych dotyczący [Olgi Tokarczuk](https://www.wikidata.org/wiki/Q254032),
możesz zobaczyć, że jest człowiekiem, polką oraz kobietą.
Wikidane to jedno z najważniejszych źródeł danych dla Goggle oraz algorytmów AI. Podczas gdy
Wikipedia służy ludziom do czytania artykułów, Wikidane zostały stworzone z myślą o maszynach. Dla
modeli językowych (LLM) oraz robotów Google Wikidane są ostateczną instancją weryfikującą fakty.
Wikidane mają mniejszy „próg wejścia”. Wystarczy, że jesteś opisany(a) w niezależnych wiarygodnych
źródłach.
Ciekawą rzeczą w Wikidanych jest deklaracja „inne niż” (ang. *different from*). Dzięki któremu można
oznaczyć, gdzie jest inna osoba o takim samym imieniu.
Dla przykładu dla odróżnienia siebie od aktora Jakuba Jankiewicza (który grał w listach do M, jak był
dzieckiem), oprócz dodania litery T. dodałem także połączone w dwie strony z mojego wpisu w Wikidanych
do wpisu aktora.


Dzięki temu, gdy jest więcej osób o takim samym imieniu i nazwisko Google i AI nadal może je od siebie
odróżnić.
## Dane strukturalne Schema.org
Nawet jeśli publikujesz w prestiżowych mediach, wydajesz książki i prowadzisz aktywne profile w
social mediach, algorytmy AI nadal muszą wykonać ogromną pracę, aby połączyć te kropki i przypisać
je do jednej, właściwej osoby. Tutaj do gry wkraczają [dane strukturalne
Schema.org](/blog/dane-strukturalne-schema-org.md). Są to specjalne meta dane, które dodaje się do
strony w formacie JSON. Dzięki nim można „podyktować” robotom wyszukiwarek i dużym modelom językowym
(jak ChatGPT, czy Gemini) strukturę Twojej marki osobistej.
W kontekście budowania marki osobistej kluczowe jest wdrożenie znacznika typu `Schema Person`
(Osoba), w którym definiujesz swoje cyfrowe uniwersum:
* **Właściwość `sameAs`:** To najważniejszy element pod kątem AI; pozwala wkleić linki do Twoich
oficjalnych profili (LinkedIn, Instagram), bazy Wikidanych, profilu autora w zewnętrznych
portalach czy konta w Google Books, co dla algorytmów jest jednoznacznym dowodem: „tak, ten autor
i ten profil to ta sama osoba”.
* **Właściwość `jobTitle` i `worksFor`:** Precyzyjnie określasz swoje stanowisko oraz firmę, którą
reprezentujesz lub której jesteś właścicielem.
* **Właściwość `alumniOf`:** Informuje algorytmy o Twojej edukacji i ukończonych uczelniach, co
automatycznie zasila kryterium Ekspertyzy (E) w systemie E-E-A-T.
* **Właściwość `publishingPrinciples`:** Wskazuje link do polityki redakcyjnej Twojego bloga,
podnosząc wskaźnik Zaufania (T).
* **Właściwość `knowsAbout`:** Pozwala wymienić konkretne tematy, branże i słowa kluczowe, w których
jesteś specjalistą, ułatwiając AI przypisanie Cię do odpowiedniej niszy.
## SEO
Czy w erze sztucznej inteligencji należy porzucić dotychczasowe działania SEO? Absolutnie
nie. Klasyczne pozycjonowanie, zdobywanie mocnych linków (Link Building) oraz walka o wysokie
pozycje w organicznych wynikach wyszukiwania, są nadal niezwykle ważne. Problem pojawia się wtedy,
gdy tradycyjne SEO jest jedyną rzeczą, którą robisz. Dzisiejsze algorytmy Google oraz wyszukiwarki
AI (takie jak Perplexity czy ChatGPT) są znacznie sprytniejsze niż jeszcze kilka lat temu i
doskonale potrafią ocenić intencje stojące za treściami.
Jeśli Twoja strategia opiera się wyłącznie na kupowaniu masowych artykułów sponsorowanych,
popełniasz poważny błąd, który AI szybko zweryfikuje:
* **Sztuczny profil linków:** Algorytmy potrafią łatwo zidentyfikować portale, które masowo
sprzedają publikacje; linki z takich miejsc mają coraz mniejszą wagę w budowaniu realnego
zaufania.
* **Brak naturalnego rezonansu:** Artykuł sponsorowany, pod którym nikt nie dyskutuje i który nie
generuje dalszych udostępnień, jest dla AI sygnałem, że treść nie niesie za sobą prawdziwej
wartości dla użytkowników.
* **Potrzeba organicznych wzmianek (Earned Media):** Prawdziwy wizerunek eksperta buduje się wtedy,
gdy za płatnymi publikacjami idą naturalne, darmowe wzmianki – sytuacje, w których inni autorzy
cytują Cię sami z siebie, bo stworzyłeś coś wartościowego.
* **Równowaga intencji:** Twoja marka w oczach AI musi wyglądać naturalnie; proporcja między
treściami komercyjnymi (opłaconymi) a organicznymi cytowaniami decyduje o autentyczności Twojego
E-E-A-T.
Jeśli wszystkie źródła o Tobie kontrolo wane są przez Ciebie, masz mała szansę, że twój wpis
w Wikidanych się utrzyma, nie mówiąc już o Wikipedii.
## Graf wiedzy Google
Graf wiedzy Google to drugi oprócz Wikidanych najbardziej znany graf wiedzy. Po dodaniu wpisu, w
Wikidanych, oraz ewentualnie Wikipedii, google może utworzyć element w swoim grafie (tzw. encje).
Graf wiedzy Google jest bezpośrednio używany przez AI overview, Tryb AI w Google oraz Gemini.
Sam graf wiedzy może spowodować pojawienie się panelu wiedzy, gdy wpisuje się imie i nazwisko
jakiejś osoby.
Poniżej przykład Olgi Tokarczuk, która ma rozbudowany panel:

Tutaj przykład mojego panelu, mniej rozbudowanego.

### Graf wiedzy a Panel Wiedzy
Wpis w grafie wiedzy Google a panel Google to dwie różne rzeczy. Możesz mieć wpis w grafie, a nie
mieć widocznego panelu. Mogą być różne powody.
### Narzędzie sprawdzania grafu wiedzy Google
Jeśli chcesz sprawdzić, czy twoja osoba znajduje się w grafie wiedzy. Możesz użyć
mojego [narzędzia do wyszukiwania encji w grafie wiedzy](/tools/graf-wiedzy/).
## Widoczność w modelach LLM
Jeśli chcesz sprawdzić, czy modele LLM mają Cię w swoich danych. Możesz użyć narzędzia
na stronie: [intheweights.com](https://www.intheweights.com/). Wpisz swoje imie i nazwisko
i sprawdź siłe swojej marki osobistej w popularnych modelach.
## Wnioski
Budowanie marki osobistej to praca na kilku frontach:
* Praca nad ekspertyzą i rozpoznawalnością (jest to często to, o czym piszą książki o marce osobistej)
* Pozycja w Google (klasyczne SEO)
* Aspekt techniczny (wikidane, dane strukturalne)
**Wszystkie aspekty muszą ze sobą współpracować.** Dopiero połączenie realnego autorytetu (książek i
publikacji) z tradycyjnym SEO i technicznym językiem maszyn (Wikidane, Schema) tworzy pełny obraz
dla sztucznej inteligencji. AI nie ocenia Cię po jednym elemencie – analizuje wszystko, co może
znaleźć na twój temat i poleci Cię użytkownikom tylko wtedy, gdy te trzy obszary będą się wzajemnie
uzupełniać.
> jeśli potrzebujesz dodać wpis do Wikipedii lub Wikidanych możesz skorzystać z mojej
> [oferty](/oferta.md), gdzie możesz umówić 15-minutową darmową konsultację.
---
### Projekt Koszulki „Jestem w Wikipedii”
Używając moich ograniczonych umiejętności designerskich, postanowiłem zaprojektować
projekt koszulki (T-shirta) dla Wikipedystów. Nazwałem projekt „Jestem w Wikipedii”.
[Ilustracja](https://commons.wikimedia.org/wiki/File:WP20Symbols_puzzleglobe2.svg), która została użyta na koszulce jest autorstwa Jasmina El Bouamraoui oraz Karabo Poppy Moletsane.
Dostępna na licencji CC0. Na takiej samej licencji są poniższe projekty koszulek.
## Przykład wydruku koszulki
Poniżej efekt finalny, czyli zdjęcie, na którym jestem w koszulce WikiTrenerskiej. Jest to koszulka typu bejsbolówka wydrukowana w [IdeaShirt](https://ideashirt.pl/?utm_source=WikiZEIT&utm_medium=article&utm_campaign=jcubic).
[](https://commons.wikimedia.org/wiki/File:Jakub_T._Jankiewicz_w_koszulce_Jestem_WikiTrenerem.jpg)
Jakub T. Jankiewicz w koszulce "Jestem Wikitrenerem"; licencja: [CC-BY-SA](https://creativecommons.org/licenses/by-sa/4.0/)
## Projekt koszulek
Poniżej projekty koszulek.
### Jestem Wikipedystą
 ### Jestem Wikipedystką
 ### Jestem WikiTrenerem
 ### Jestem WikiTrenerką
 ## Link do Commons
Link do [kategorii z grafikami na Wikimedia Commons](https://commons.wikimedia.org/wiki/Category:Jestem_w_Wikipedii).
---
### Dokumentacja Eksponatów w Muzeum 'Domek Tkaczki'
W pierwszej połowie czerwca 2026 wykonałem sesję fotograficzną, dokumentującą eksponaty w [Muzeum
Dawnej Wsi „Domek Tkaczki”](https://www.domektkaczki.pl/).
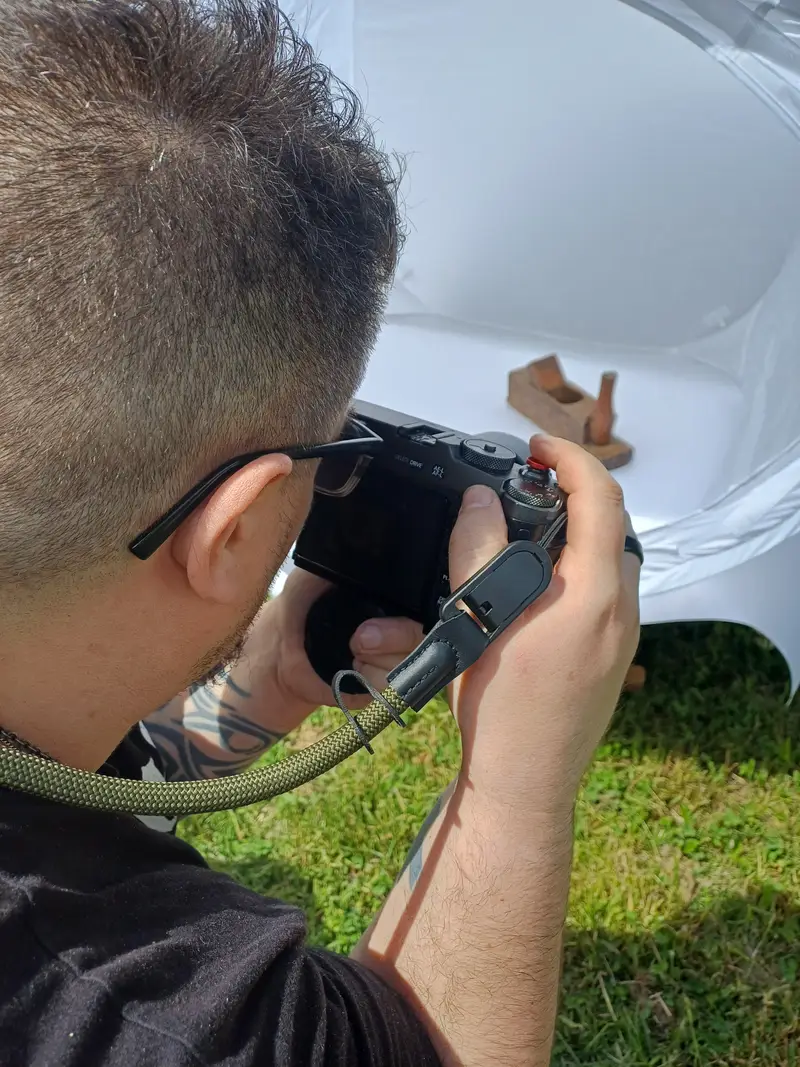
Jakub T. Jankiewicz wykonujący zdjęcie, fot. [Urszula Wolska](https://wolska.jcubic.pl), Wszystkie prawa zastrzeżone
## Zdjęcia eksponatów z Domku Tkaczki
Przykładowe zdjęcia wykonane aparatem Fuji X-Pro 3.
### Czółenko
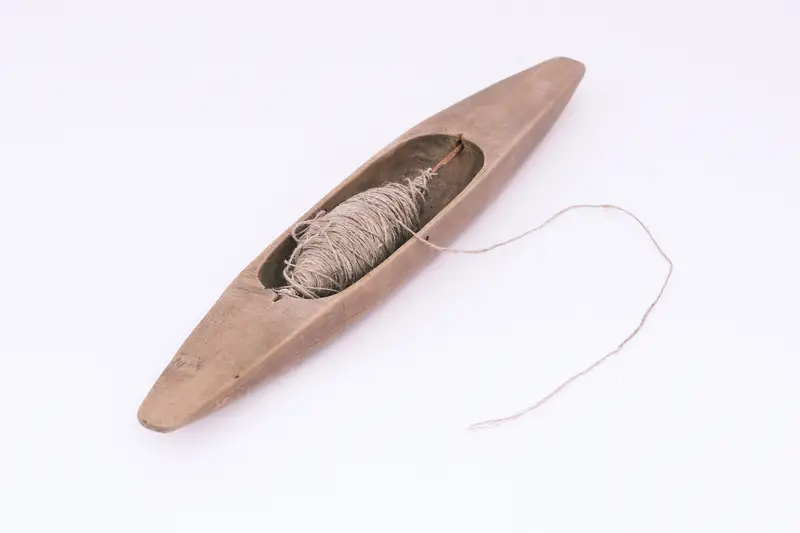
Czółenko, fot. [Jakub T. Jankiewicz](https://jakub.jankiewicz.org/), licencja: [CC-BY-SA](https://creativecommons.org/licenses/by-sa/4.0/)
### Drewniana Piasta
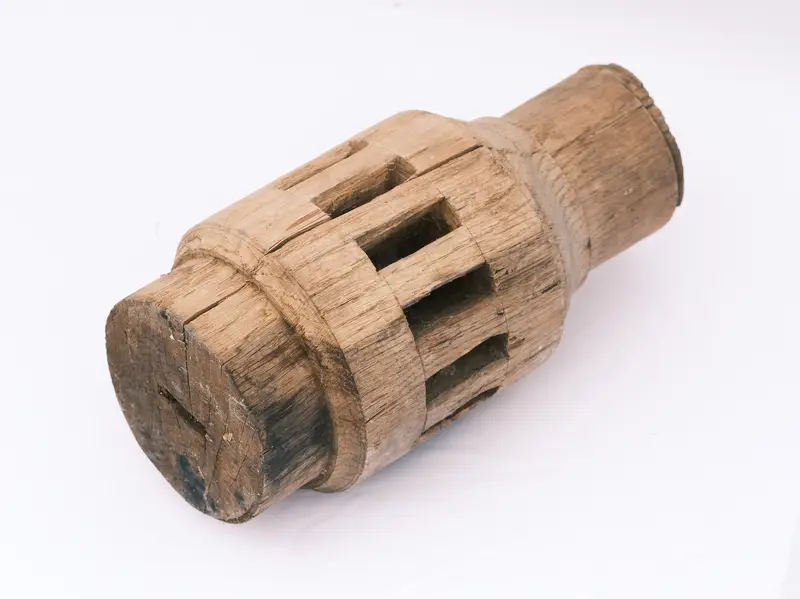
Drewniana Piasta, fot. [Jakub T. Jankiewicz](https://jakub.jankiewicz.org/), licencja: [CC-BY-SA](https://creativecommons.org/licenses/by-sa/4.0/)
### Strug
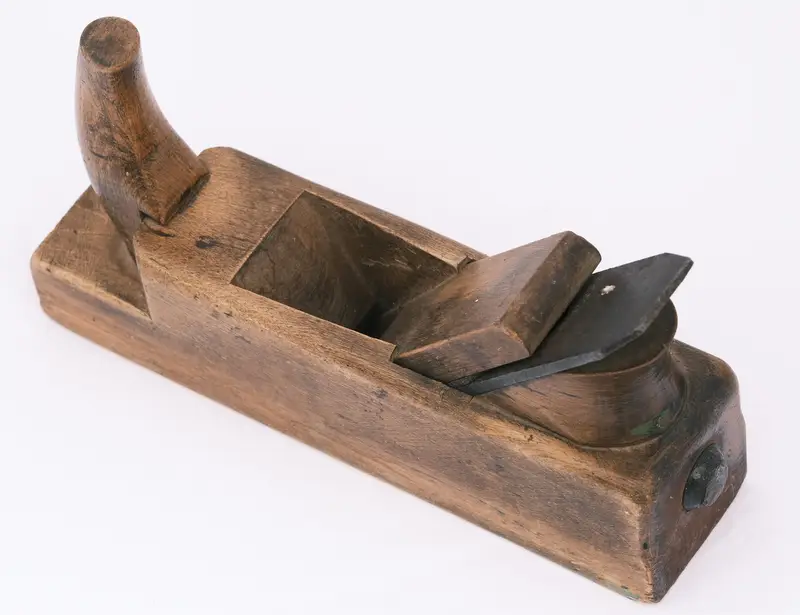
Strug, fot. [Jakub T. Jankiewicz](https://jakub.jankiewicz.org/), licencja: [CC-BY-SA](https://creativecommons.org/licenses/by-sa/4.0/)
Więcej zdjęć z sesji na Wikimedia Commons w kategorii: [Collections of Muzeum Dawnej Wsi Domek Tkaczki](https://commons.wikimedia.org/wiki/Category:Collections_of_Muzeum_Dawnej_Wsi_Domek_Tkaczki).
---
### Jak napisać bota do Wikipedii
## Co takiego jest bot?
Bot jest to specjalny program komputerowy, który używa dodatkowego konta jakiegoś
[Wikipedysty](https://pl.wikipedia.org/wiki/Społeczność_wikipedystów).
Taki program może wykonywać różne automatyczne działania w Wikipedii, najczęściej jakieś
automatyzacje np. globalne poprawki w artykułach lub jakieś konkretne działania edycyjne.
W tym artykule opiszę jak stworzyć prostego bota przy użyciu języka programowania
[Python](https://pl.wikipedia.org/wiki/Python).
## Instalacja Pythona
Pierwsza rzecz to instalacja Pythona, najlepiej jest wyszukać w Google "jak zainstalować pythona"
oraz nasz system operacyjny. Instalacja będzie się różnić między Windowsem, MacOS oraz Linux.
Pod systemami Linux dodatkowo należy zainstalować [PIP](https://pl.wikipedia.org/wiki/Pip_(menadżer_pakietów)),
czyli manager paczek Pythona.
## Biblioteka pywikibot
Po instalacji Pythona i PIP należy zainstalować paczkę `pywikibot` jest to biblioteka,
za pomocą której można automatyzować działania w Wikipedii. W tym celu w terminalu należy wynikać polecenie:
```bash
pip install pywikibot
```
### Dlaczego warto korzystać z pywikibot?
[API](https://pl.wikipedia.org/wiki/Interfejs_programowania_aplikacji)
[MediaWiki](https://pl.wikipedia.org/wiki/MediaWiki) (silnika napędzającego Wikipedię) jest bardzo rygorystyczne. Jednym z kluczowych
wymogów bezpieczeństwa jest przesyłanie unikalnego i poprawnego nagłówka
[User-Agent](https://pl.wikipedia.org/wiki/User_agent) przy każdym
zapytaniu [HTTP](https://pl.wikipedia.org/wiki/HTTP). Dzięki temu administratorzy wiedzą, jaki bot generuje ruch.
Wielką zaletą pywikibot jest to, że obsługuje nagłówek User-Agent w pełni automatycznie. Framework
sam generuje go na podstawie Twojego pliku konfiguracyjnego, łącząc nazwę bota z wersją
biblioteki. Dzięki temu nie musisz ręcznie konfigurować sesji HTTP ani martwić się o niespodziewane
blokady adresu IP ze strony serwerów Wikimedia.
Drugą rzeczą jest [rate limit](https://en.wikipedia.org/wiki/Rate_limiting), które biblioteka ogarnia.
## Tworzenie hasła dla bota
Korzystając z biblioteki `pywikibot`, można zalogować się do swojego konta za pomocą
hasła do Wikipedii, ale w przypadku botów, nie jest do za bardzo bezpieczne.
A gdy, tak jak w moim przypadku, masz ustawione
[podwójne uwierzytelnianie](https://pl.wikipedia.org/wiki/Uwierzytelnianie_wieloskładnikowe),
nie będzie to możliwe.
Dlatego w Wikipedii jest możliwość stworzenia specjalnego hasła dla bota.
Coś podobnego do [API Key](https://en.wikipedia.org/wiki/API_key) w różnego rodzaju usługach.
Wchodzimy na stronę: [Specjalna:Hasła_botów](https://pl.wikipedia.org/wiki/Specjalna:Hasła_botów)
i dodajemy nowe hasło:

formularz dodawania hasła bota
klikamy „utwórz” i wybieramy uprawnienia:

uprawnienia bota z zaznaczonymi uprawnieniami do edycji i tworzenia stron
Po wybraniu uprawnień dodawania i edycji stron, na dole strony klikamy „utwórz”:

nowe wygenerowane hasło bota
Po utworzeniu powinno się pojawić losowe hasło, zapisz je sobie, będziemy go używać za chwilę.
## Bot Hello World przez API
Najprostsze użycie biblioteki pywikibot, która doda nową stronę do Wikipedii w twojej przestrzeni
użytkownika wygląda tak.
```python
import pywikibot
def main():
# 1. Inicjalizacja połączenia z polską Wikipedią (używa user-config.py)
site = pywikibot.Site('pl', 'wikipedia')
# 2. Wskazanie konkretnej strony w Twoim brudnopisie
page = pywikibot.Page(site, 'Wikipedysta:Jcubic/HelloBot')
# 3. skrypt
if page.exists():
print("Błąd: Podana strona testowa już istnieje!")
return
# 4. Dodanie nowego tekstu
page.text = "Witaj, Wikipedio!"
# 5. Zapisanie zmodyfikowanej strony z opisem zmian
page.save(
summary="[WikiZEIT Test] Pierwsze uruchomienie bota Hello World przez API",
minor=True
)
print("Sukces! Strona została utworzona.")
if __name__ == '__main__':
main()
```
* `pywikibot.Site()` - zwraca obiekt. który umożliwia dostęp do danego projektu.
* `pywikibot.Page()` - zwraca obiekt konkretnej strony, strona nie musi istnieć.
* `page.exists()` - sprawdza, czy strona istnieje.
* `page.text` - to accessor, który zawiera tekst strony.
* `page.save()` - zapisuje stronę.
## Logowanie do Wikipedii
Aby nasz bot mógł się zalogować do Wikipedii należy utworzyć plik `user-config.py`
Jego zawartość powinna wyglądać tak:
```python
family = 'wikipedia'
mylang = 'pl'
usernames['wikipedia']['pl'] = 'jcubic' # tutaj wstaw swój nick
password_file = 'user-password.py'
```
Plik `user-password.py` powinien zawierać krotkę, która wygląda tak:
```python
('Jcubic', BotPassword('Hello-World', 'r4qli70elje53e48s8lqf4oddnmrjjer'))
```
Oczywiście musisz wpisać swoje własne hasło bota.
Teraz możemy uruchomić nasz skrypt, wynikiem powinno być coś takiego:
```text
Logging in to wikipedia:pl as Jcubic@Hello-World
Sleeping for 7.4 seconds, 2026-06-07 21:52:31
Page [[Wikipedysta:Jcubic/HelloBot]] saved
Sukces! Strona została utworzona.
```
Wchodzą na Wikipedię i zaglądając do naszych edycji na stronie
[Specjalna:Wkład/Jcubic](https://pl.wikipedia.org/wiki/SSpecjalna:Wkład/Jcubic),
widzimy edycje bota:

historia edycji z opisem "\[WikiZEIT Test] Pierwsze uruchomienie bota Hello World przez API"
A wchodzą na stronę w naszej przestrzeni nazw możemy zobaczyć nasz tekst:

strona Wikipedysta:Jcubic/HelloBot z tekstem Witaj, Wikipedio!
## Rejestracja konta bota
Jeśli zamierzasz stworzyć prawdziwego bota, musisz zarejestrować nowe konto dla niego.
Jeśli nie chcesz wylogowywać się z Wikipedii, możesz zrobić to w oknie incognito lub
otworzyć inną przeglądarkę.
Po założeniu konta, na stronie użytkownika, musimy wpisać informacje że jest to konto bota:

Kod strony użytkownika bota Wikipedysta:WikiZEITBot z opisem jego działania
Powyższy opis dotyczy mojego bota, którego zacząłem tworzyć razem podczas pisania tego artykułu.
Tak wygląda zapisana strona:
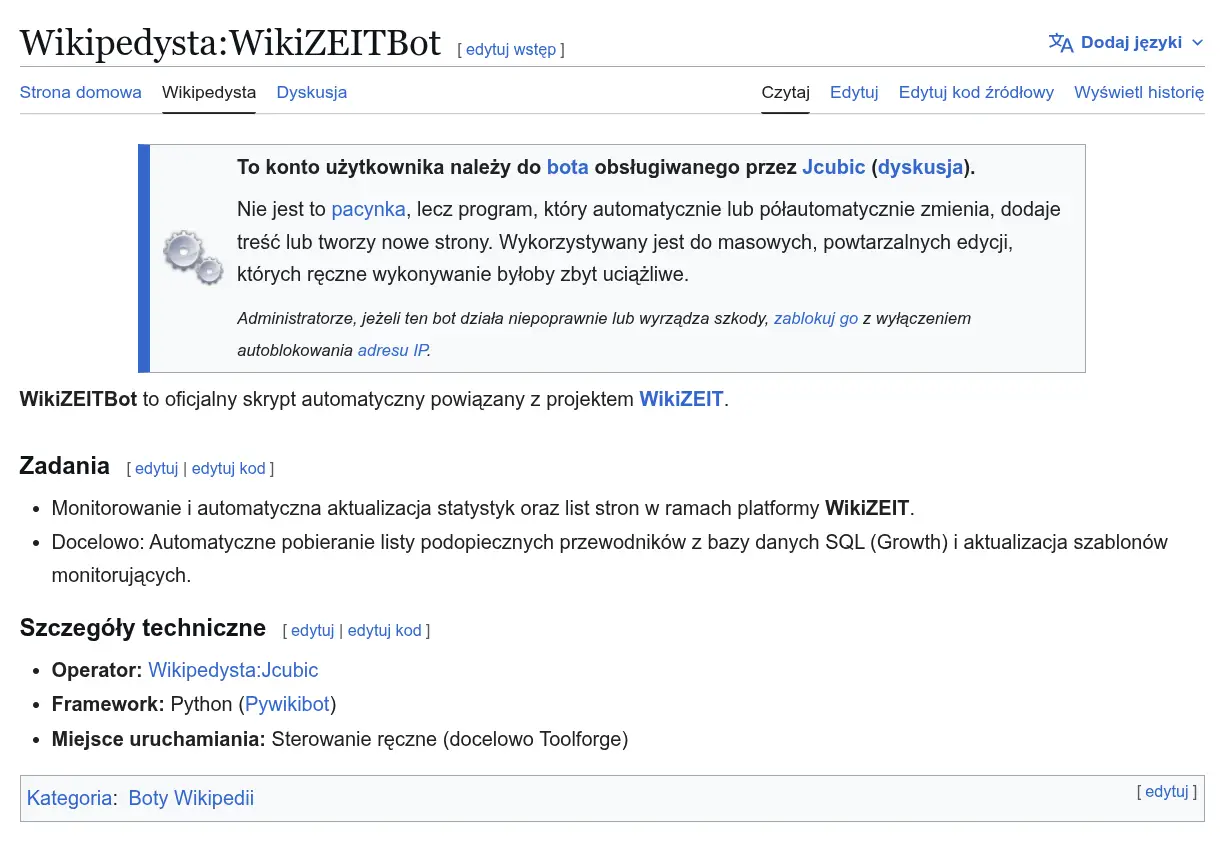
Wynikowa zapisana strona z banerem, na początku który mówi, że jest to konto bota
Najważniejsze jest dodanie szablonu
{% raw %}
```text
{{Szablon:Bot|Jcubic}}
```
{% endraw %}
Aby poinformować, że jest to bot.
## Legalizacja bota
Następnym wymaganym krokiem jest zgłoszenie naszego bota na stronie
[Wikipedia:Boty/Zgłoszenia](https://pl.wikipedia.org/wiki/Wikipedia:Boty/Zgłoszenia).
Dzięki temu jeden z [Biurokratów](https://pl.wikipedia.org/wiki/Wikipedia:Biurokraci),
doda nam flagi, dzięki którym będziemy mogli używać bota legalnie.
Na stronie ze zgłoszeniami należy kliknąć złóż wniosek:

Instrukcja jak złożyć wniosek dotyczący bota
Wypełnić formularz:

formularz jako kod wiki
Tak wyglądał mój wniosek:

Wynikowy wypełniony formularz z oznaczeniem nowy
Warto obserwować [stronę z wnioskami](https://pl.wikipedia.org/wiki/Wikipedia:Boty/Zgłoszenia/Wnioski)
oraz mieć włączone powiadomienia email, gdy obserwowana strona się zmieni.
## Co dalej?
Następny krokiem jest napisanie kodu bota, który zrealizuje cel, jaki chcemy osiągnąć. Moim celem
jest pomoc przewodnikom w monitorowaniu swoich podopiecznych.
### Czym jest Wikimedia Toolforge?
Dobrze jest także uniezależnić bota od własnego komputera. Wikimedia udostępnia specjalne
środowisko chmurowe o nazwie Toolforge. Jego celem jest utrzymywanie narzędzi, które pomagają w
edycji projektów Wikimediów.
Dzięki temu nasz bot może działać nawet, jak nasz komputer nie jest włączony.
## Podsumowanie
Boty to potężne narzędzia, które potrafią w kilka sekund wykonać pracę wymagającą od człowieka wielu
dni żmudnego klikania. Należy pamiętać o słowach mędrca: „[With great power comes great
responsibility](https://en.wikipedia.org/wiki/With_great_power_comes_great_responsibility)”. Automatyzacja
edycji na żywym organizmie, jakim jest Wikipedia, niesie za sobą duże ryzyko. Wadliwy kod w pętli
może w krótkim czasie uszkodzić setki artykułów, dlatego najlepiej jest testować jego działanie w
swoim brudnopisie.

Figurka: Stan Lee - Excelsior!
Informacje na temat mojego bota można znaleźć na [tej stronie](/projekty/wikizeitbot/).
---
### Konkursy Fotograficzne Wikimedia Commons
## Co to jest Wikimedia Commons?
Wikimedia Commons są to zasoby multimedialne Wikipedii i innych projektów tzw. siostrzanych.
Mimo że znajdują się tam różne pliki, jednak głównymi zasobami w Wikimedia Commons są zdjęcia.
Wszystkie zdjęcia udostępnione na wolnych licencjach Creative Commons.
Wikimedia Commons jest to projektem wielojęzycznym, tzn. nie ma innych wersji językowych, jak w przypadku
Wikipedii. Jest jeden portal na stronie [commons.wikimedia.org](https://commons.wikimedia.org/),
natomiast można zmienić język interfejsu. Opisy zdjęć można dodawać w różnych językach. Więc szukając
Czegoś, w zasobach Commons, trzeba pamiętać o sprawdzenie nazw polskich, jak i angielskich.
## Co to są licencje Creative Commons?
Jest to zestaw licencji prawa autorskiego, które zmienia, w jaki sposób działa to prawo. Domyślnie
każde kreatywne dzieło człowieka, np. zdjęcie, filmy, artykuł na blogu, są objęte prawem autorskim.
Domyślnie oznacza to: "Wszystkie Prawa Zastrzeżone" (po angielsku "All Right Reserved") i nikt nie
może kopiować danego dzieła bez zgody autora. Nie jest wymagane opisanie danego dzieła w żaden sposób
np. poprzez dopisanie notki Copyright, prawo autorskie działa automatycznie.
Natomiast licencje Creative Commons, zmieniają zasady działania prawa autorskiego. Dając pewne prawa
do kopiowania danego dzieła. Prawa, o których decyduje autor dzieła.
Licencje te dają kilka klocków, które można łączyć kombinacje. Oto one:
* Attribution - uznanie autorstwa - BY
* Non-Derivative - bez utworów zależny - ND
* Non-Commercial - bez użytku komercyjnego - NC
* Share-Alike - na tych samych warunkach - SA
Każda licencje (z jednym wyjątkiem, o którym za chwilę) musi mieć człon BY (czyli uznanie autorstwa)
Oznacza to, że używając np. zdjęcia na licencji Creative Commons, trzeba podpisać, kto je zrobił.
Przykłady:
* BY - najbardziej liberalna, oznacza że dzieło można używać w dowolny sposób tylko trzeba podpisać
kto jest autorem.
* BY-NC-SA - oznacza że nie można użyć do celów komercyjnych a każda modyfikacja musi mieć taką samą
licencje.
* BY-SA - jest to licencja, której zazwyczaj używam, oznacza to samo co wyżej tylko można
wykorzystywać do celów komercyjnych.
## Creative Commons Zero
Jest to specjalna licencja, która oznacza, że dzieło jest w [Domenie
Publicznej](https://pl.wikipedia.org/wiki/Domena_publiczna). Czyli tak jakby nie miało żadnych praw
autorskich. Do domeny publicznej zazwyczaj przechodzą dzieła, których ochrona prawo autorska
wygasła. Zazwyczaj, ponieważ autor umarł dawno temu. W Polsce aktualnie jest to 70 lat. Przy czym
jest to trochę bardziej skomplikowane dla dzieł, które nie mają znanego autora.
## Historia licencji Creative Commons
Creative Commons zainicjował [Lawrence Lessig](https://pl.wikipedia.org/wiki/Lawrence_Lessig),
amerykański profesor prawa na Harvardzie. Idea licencji wzięła się prawdopodobnie z ruchu Otwartego
Oprogramowania, które z kolei było bardziej przystępną, dla korporacji, wersją Wolnego Oprogramowania.
Problem z Wolnym Oprogramowaniem był taki, że po angielsku Wolny to Free, co ma takie samo znaczenie
jak darmowy. Było to problematyczne z punktu widzenia biznesu, którego głównym celem jest zarabianie pieniędzy.
Wprowadzenie "marki" Open Source otwarło drzwi i rozprzestrzeniło idee wolności na cały świat.
Jeśli interesuje cię historia ruchu Open Source, która związana jest z Linuxem, polecam film dokumentalny:
[Revolution OS](https://en.wikipedia.org/wiki/Revolution_OS), dostępny w serwisie YouTube.
Dzisiaj mamy, otwartą wiedzę, otwartą naukę, otwarte dane. A wszystko to dzięki Creative Commons, które przeniosło
idee Open Source, dotyczącą programów komputerowych, na inne kreatywne dzieła oraz inną działalność człowieka.
Warto wspomnieć, że duży wpływ, na licencje Creative Commons, miał [Aaron
Swartz](https://pl.wikipedia.org/wiki/Aaron_Swartz). Aktywista, który zginął śmiercią
samobójczą. Przez wielu uważany za męczennika w obronie dostępu do wiedzy.
Historie Aarona można obejrzeć w filmie dokumentalnym: [The Internet's Own Boy: The Story of Aaron
Swartz](https://en.wikipedia.org/wiki/The_Internet%27s_Own_Boy).
## Licencje w Wikimedia Commons
Wróćmy do Wikipedia Commons. Jest to miejsce, gdzie można udostępnić, między innymi, swoje zdjęcia, które jednak
trzeba udostępnić na licencji Creative Commons. Istnieje jednak zastrzeżenie, że dzieła mogą być tylko na trzech
rodzajach licencji. Wszystkie nie są dozwolone. Są nimi:
* CC-BY - uznanie autorstwa
* CC-BY-SA - uznanie autorstwa, na tych samych warunkach
* CC-0 - domena publiczna
Wymóg ten jest podyktowany tym, że każdy musi mieć wolność modyfikacji danego działa, oraz musi mieć
możliwość używania do celów komercyjnych.
## Ochrona Wizerunku
Nie trzeba się obwiać, np. publikując zdjęcia jakieś osoby, ponieważ w Polsce istnieje prawo ochrony wizerunku.
Więc nawet jak zdjęcie ja na licencji CC-0 (bez praw autorskich) nie można sobie, od tak, użyć czyjegoś wizerunku,
np. na plakacie, czy w reklamie. Musi się uzyskać zgodę danej osoby.
Taka ochrona jest automatyczna, tak jak w przypadku prawa autorskiego. Ale można dodatkowo oznaczyć dane dzieło
specjalnym oznaczeniem (w projektach Wikimediowych nazywaną szablonem)
[Personality rights](https://commons.wikimedia.org/wiki/Template:Personality_rights).
## Dzieła nieobjęte prawem autorskim
Trzeba zaznaczyć, że niektóre twory człowieka nie spełniają warunków bycia kreatywnym dziełem. Różne kraje mają inne
wymagania w tej sprawie. Przykładem są proste logotypy, które oznaczone są jako niemające praw autorskich, bo są
to proste geometryczne kształty. Taką grafiką może być np. logo Google:

Ważne jest jednak aby pamiętać o tym, że mimo że loga nie mają ochrony prawno autorskiej, mogą mieć ochronę
jako [znak towarowy](https://pl.wikipedia.org/wiki/Znak_towarowy).
Więc tak jak w przypadku ochrony wizerunku, nie można sobie bez karnie używać tego typu grafik do własnych celów.
Przykładem szczególnej ochrony są logotypy Wikimedia Foundation (takie jak logo Wikipedii), które są chronione znakiem towarowym.

Wikimedia Foundation, author [Neolŭ](https://en.wikipedia.org/w/index.php?oldid=738322287); Domena Publiczna; [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Wikimedia_Foundation_logo_-_vertical.svg)
Użycie znaków towarowych Wikimedia Foundation zostało opisane na stronach:
* [Polityka znaków towarowych](https://foundation.wikimedia.org/wiki/Policy:Wikimedia_Foundation_Trademark_Policy/pl)
* [Identity guidelines](https://foundation.wikimedia.org/wiki/Legal:Visual_identity_guidelines)
Jakby ktoś pytał, użycie w artykule opisującym projekty Wikipedia jest dozwolone. Ale już np. użycie w celach komercyjnych,
np. użycie w celach promocji płatnych edycji (które realizuje WikiZEIT) nie jest dozwolone. Dlatego na stronie
[oferta](/oferta.md), gdy mam obrazek, który wyświetla się w mediach społecznościowych (po wklejeniu linka) mam grafikę wygenerowaną
przez AI.

ChatGPT; Domena Publiczna; [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Wikipedia_puzzle.png)
## Twory wygenerowane przez sztuczną inteligencję
Uznane zostało, że twory wygenerowane przez sztuczną inteligencję, tak jak wszystkie twory, nie
stworzone przez człowieka, np. zwierze, Nie posiadają praw autorskich.
Przykładem tworu, który prawdopodobnie był powodem uznania dzieł AI jako niemającego prawa autorskiego jest
historia [Małpiego Selfie](https://pl.wikipedia.org/wiki/Małpie_selfie).

Makak Naruto; Aparat Davida Slatera; Domena Publiczna; [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Macaca_nigra_self-portrait.jpg)
Zdjęcie wykonała Makak zwany Naruto, aparatem Davida Slatera. Sąd uznał, że dzieło jest w domenie publicznej, ponieważ nie
zostało wykonanie przez człowieka. Jeśli jesteś zainteresowany szczegółami historii, sprawdź artykuł w Wikipedii (link powyżej).
## Konkursy Fotograficzne
Po tym długim wstępie, o zasadach Wikimedia Commons, przejdzmy do istoty wpisu, czyli konkursów
fotograficznych w Wikimedia Commons:
### Wiki Lubi Zabytki
Jest to największy konkurs fotograficzny organizowany przez Wikimedia Foundation. Jeden z dwóch, w
których aktywny udział bierze Polska, dzięki wsparciu [Wikimedia
Polska](https://pl.wikimedia.org/wiki/Wiki_Lubi_Zabytki). **Wiki Lubi Zabytki** (międzynarodowa
nazwa: *Wiki Loves Monuments*) to konkurs fotograficzny, którego celem jest wizualne udokumentowanie
historycznego dziedzictwa materialnego. W Polsce konkurs organizowany jest tradycyjnie każdego roku
przez cały wrzesień. Do konkursu można zgłaszać fotografie [zabytków
nieruchomych](https://pl.wikipedia.org/wiki/Zabytek_nieruchomy), które znajdują się w rejestrach
[Narodowego Instytutu Dziedzictwa](https://pl.wikipedia.org/wiki/Narodowy_Instytut_Dziedzictwa).
Gdy konkursy, z wszystkich krajów się skończą (różne kraje organizują konkurs w różnych miesiącach
jesieni), następuje wyłonienie najlepszych zdjęć w konkursie międzynarodowym.
Moje zdjęcie wygrało IV miejsce w Polsce oraz III w konkursie międzynawowym w 2022 roku:

Jaszczórówka (Zakopane) nocą; CC-BY-SA 4.0; [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Jaszczurówka_at_Winter.jpg)
### Wiki Science Competition
Drugim konkursem fotograficznym, w którym bierze udział Polska, jest Wiki Science Competition. Jest
to konkurs organizowany co dwa lata. Organizowany w 2021, 2023 oraz 2025. Kolejna edycja
w 2027. Jego celem jest udokumentowanie świata nauki i przyrody.
Poniżej strony z wyróżnionymi zdjęciami w Polsce:
* [Wyniki konkursu z 2021 roku](https://pl.wikipedia.org/wiki/Wikipedia:Wiki_Science_Competition_2021/Wyniki/2021)
* [Wyniki konkursu z 2023 roku](https://pl.wikipedia.org/wiki/Wikipedia:Wiki_Science_Competition_2023/Wyniki/2023)
* [Wyniki konkursu z 2025 roku](https://pl.wikipedia.org/wiki/Wikipedia:Wiki_Science_Competition_2025/Wyniki)
Tak jak w przypadku Wiki Lubi Zabytki jest też etap międzynarodowy.
### Konkursy międzynarodowe
Oba powyższe konkursy organizowane są w dwóch etapach, lokalnym danego kraju, oraz międzynarodowym, gdzie wybrane są najlepsze
zdjęcia z całego świata. Oprócz tych wyżej wymienionych istnieją także konkursy, w których Polska nie bierze udziału.
#### Wiki Love Earth
Wiki Loves Earth (WLE) to międzynarodowy konkurs fotograficzny skupiający się na dokumentowaniu
naturalnego dziedzictwa naszej planety. W Polsce organizowany był tylko raz w 2015 roku pod nazwą [Wiki Lubi
Przyrodę](https://pl.wikipedia.org/wiki/Wikipedia:Wiki_Lubi_Przyrodę).
#### Wiki Love Folklor
Wiki Loves Folklore to międzynarodowy konkurs multimedialny odbywający się co roku od 1 lutego
do 31 marca. Jego celem jest udokumentowanie niematerialnego dziedzictwa kulturowego – tradycji,
obrzędów, tańców, strojów ludowych, rzemiosła oraz kuchni regionalnej z całego świata.
W odróżnieniu od Wiki Love Earth, Polacy mogą brać udział w Wiki Love Folklor, mimo że Polska nie
organizuje własnej edycji. Wystarczy [zgłosić zdjęcie bezpośrednio do etapu
międzynarodowego](https://commons.wikimedia.org/wiki/Commons:Wiki_Loves_Folklore_2026/pl).
#### Picture of the Year
[Picture of the Year](https://commons.wikimedia.org/wiki/Commons:Picture_of_the_Year) jest to
konkurs na najlepsze zdjęcie z całego roku, które trafiło do Commons. Jest to wyróżnienie, za które
nie przyznawane są nagrody.
#### Monthly Photo Challenge
Oprócz konkursów, w Commons, organizowane są wyzwania trwające cały miesiąc. Wybierane są dwa tematy, które można zgłaszać do wyzwania.
Tak jak w przypadku Picture of the Year, za wygraną w wyzwaniu, nie są przyznawane żadne nagrody.
Więcej o wyzwaniach na stronie Wikimedia Commons: [Foto wyzwanie](https://commons.wikimedia.org/wiki/Commons:Photo_challenge/pl).
## Podsumowanie
Głównym celem konkursów jest wzbogacanie zasobów Commons o darmowe, wysokiej jakości pliki
multimedialne, które mogą, chociaż nie muszą, ilustrować artykuły w Wikipedii. Jednocześnie projekty
te aktywizują globalną społeczność fotografów, zachęcając ich do dzielenia się swoją twórczością na
wolnych licencjach.
Podobnie jak w innych tego typu konkursach, organizowanych na całym świecie, tutaj również na
zwycięzców czekają realne nagrody finansowe i rzeczowe. Dla wielu autorów największą motywacją
pozostaje jednak prestiż i świadomość, że ich zdjęcia będą codziennie ilustrować wiedzę dla milionów
ludzi na całym świecie.
---
### Płatna Edycja Wikipedii w Polsce
W dzisiejszym świecie Wikipedia to coś więcej niż encyklopedia – to cyfrowy fundament zaufania. Dla
firmy lub osoby publicznej obecność w tym serwisie jest ostatecznym potwierdzeniem statusu i
autorytetu. Należy jednak pamiętać, że granica między rzetelną informacją a zakazaną promocją jest
niezwykle cienka, a jej przekroczenie kończy się natychmiastowym usunięciem treści.
## Czy płatna edycja Wikipedii jest zgodna z zasadami?
Wiele osób zastanawia się, czy płacenie za edycję nie łamie zasad Wikipedii. Krótka odpowiedź brzmi:
**jest to ok, pod warunkiem pełnej transparentności.** Fundacja Wikimedia wymaga, aby każda płatna
edycja była oznaczona deklaracją **Konfliktu Interesów
([WP:KI](https://pl.wikipedia.org/wiki/WP:KI))**. Społeczność Polskiej Wikipedii nie ma
wypracowanych własnych zasad dotyczących płatnej edycji, więc funkcjonują zasady ogólne.
Zobacz: [Paid Editing Disclosure](https://wikimediafoundation.org/story/paid-editing-disclosure/)
oraz [Terms of Use](https://foundation.wikimedia.org/wiki/Policy:Terms_of_Use/pl).
Warto jednak wiedzieć, że większość najbardziej aktywnych i zaangażowanych redaktorów polskiej
Wikipedii podchodzi do płatnych zleceń z dużą niechęcią i rzadko podejmuje się takiej współpracy,
preferując wolontariat i dbanie o czystość merytoryczną haseł.
## Widoczność w Google oraz AI
Wikipedia to "paliwo" dla algorytmów. Jej znaczenie wykracza poza samą witrynę:
* **Graf wiedzy Google (Google Knowledge Graph):** Wpis w Wikipedii niemal gwarantuje pojawienie się
Panelu Wiedzy po prawej stronie wyników wyszukiwania.
* **Sztuczna Inteligencja:** Modele takie jak ChatGPT czy Google Gemini traktują Wikipedię jako
jedno z głównych źródeł prawdy przy generowaniu odpowiedzi.
* **Pełny panel wiedzy:** Aby uzyskać rozbudowany profil ze zdjęciami i powiązanymi artykułami, sama
**encja** w Grafie Wiedzy nie wystarcza, wymagana jest także duża widoczność w mediach oraz
silna marka osobista.
## Mit "czyszczenia wizerunku" vs. rzeczywistość
Wikipedia nie służy do PR-u. Jeśli firma ma na koncie głośny skandal opisany w rzetelnych źródłach,
próba usunięcia tych informacji przez płatnego edytora jest skazana na porażkę. Zgodnie z zasadą
**Neutralnego Punktu Widzenia ([WP:NPOV](https://pl.wikipedia.org/wiki/WP:NPOV))**, artykuł musi
przedstawiać pełen obraz – zarówno sukcesy, jak i kontrowersje.
## Kryterium Encyklopedyczności: Największa bariera wejścia
To najważniejszy punkt: **jeśli potrzebujesz Wikipedii, aby stać się zauważalnym w mediach, to
prawdopodobnie nie nadajesz się do Wikipedii.** Encyklopedia dokumentuje istniejący stan rzeczy,
a nie go kreuje.
* Firmy i osoby naprawdę encyklopedyczne często nie potrzebują tej promocji.
* Wpis ma być koroną wieńczącą wizerunek, a nie fundamentem kampanii marketingowej.
* Weryfikacja jest bezlitosna – brak wystarczającego "szumu" w mediach oznacza usunięcie artykułu.
## Źródła, czyli fundament każdego wpisu
W Wikipedii nie liczy się to, co wiesz, ale to, co możesz udowodnić. Jedna z głównych zasad to
weryfikowalność czyli [WP:WER](https://pl.wikipedia.org/wiki/WP:WER)
* **Akceptowalne źródła:** Ogólnopolskie media informacyjne, książki, recenzowane czasopisma,
artykuły naukowe.
* **Źródła odrzucane:** Artykuły sponsorowane, komunikaty prasowe, własna strona WWW, media
społecznościowe oraz wszelkie źródła zależne od podmiotu.
* **Ważne:** Edycje bez przypisów mogą zostać usunięte bez podania przyczyny. Obowiązuje zakaz
tzw. **twórczości własnej ([WP:NOR](https://pl.wikipedia.org/wiki/WP:NOR))** – nie piszemy "z
głowy", nawet jeśli jesteśmy ekspertami.
## Prawa autorskie
Kopiowanie treści to najprostsza droga do blokady. Nawet jeśli jesteś autorem tekstu na swojej
stronie firmowej, **nie możesz go wkleić do Wikipedii**. Wszystkie treści tam zawarte muszą być
dostępne na wolnej licencji [Creative
Commons](https://pl.wikipedia.org/wiki/Creative_Commons). Proces legalizacji treści przez system
OTRS/VRTS jest skomplikowany, dlatego najlepiej pisać artykuły od zera, własnymi słowami. Ale
pamiętać trzeba o źródłach. Bazujemy na informacjach, ale ich nie kopiujemy. Chyba że jest to mały
fragment, udostępniony na zasadach [cytatu](https://pl.wikipedia.org/wiki/Cytat).
## Treść generowana przez AI a Wikipedia – zasady i ryzyka
W dobie popularności ChatGPT i innych modeli LLM, pokusa generowania haseł przez AI (Artificial
Intelligence) jest duża. Jednak polska Wikipedia podchodzi do tego bardzo restrykcyjnie (zgodnie z
zaleceniami społeczności):
* **Pełna odpowiedzialność edytora:** To Ty (człowiek) odpowiadasz za każde słowo wprowadzone do
encyklopedii. Jeśli AI "zmyśli" fakt lub źródło (tzw. halucynacje), konsekwencje ponosi autor
wpisu, co często kończy się blokadą konta.
* **Weryfikacja źródeł:** Modele AI mają tendencję do tworzenia nieistniejących przypisów. Każda
informacja wygenerowana przez SI musi zostać ręcznie sprawdzona w rzeczywistych źródłach.
* **Problemy ze stylem i redundancją:** Teksty z AI są często "puste" informacyjnie, zawierają
dużo zbędnych przymiotników i ogólników, co jest sprzeczne z encyklopedycznym stylem.
* **Prawa autorskie i unikalność:** Wikipedia wymaga treści unikalnych. Bezmyślne kopiowanie
odpowiedzi z AI może naruszać zasady dotyczące jakości i być traktowane jako spam.
**Wniosek:** AI może być pomocnikiem w tłumaczeniu tekstów lub poprawianiu gramatyki, ale nigdy nie
powinno być jedynym autorem artykułu. Płatna edycja oparta wyłącznie na "copy-paste" z ChataGPT to
najkrótsza droga do usunięcia wpisu.
## Jak dodać firmę do Wikipedii? – proces krok po kroku
1. **Analiza źródeł:** Sprawdź, czy o firmie pisały niezależne media (nie lokalne, nie branżowe).
2. **Przygotowanie szkicu:** Stwórz tekst w brudnopisie, dbając o encyklopedyczny styl.
3. **Deklaracja [WP:KI](https://pl.wikipedia.org/wiki/WP:KI):** Poinformuj na swojej stronie
użytkownika o powiązaniach z firmą.
4. **Publikacja i weryfikacja:** Poproś swojego przewodnika o sprawdzenie i publikację, jeśli masz
konto od niedawna. Jeśli jesteś w Wikipedii już od [jakiegoś
czasu](https://pl.wikipedia.org/wiki/WP:AC), możesz przenieść artykuł do przestrzeni głównej
sam(a). Prośbę o sprawdzenie można także zgłosić na stronie
[Wikipedia:Pytania_nowicjuszy](https://pl.wikipedia.org/wiki/Wikipedia:Pytania_nowicjuszy).
## Jak stworzyć biografię osoby (np. CEO lub eksperta)?
Wymagania dla biografii osób żyjących (BIO) są jeszcze surowsze. Należy wykazać, że osoba ta wywarła
istotny, trwały wpływ na swoją dziedzinę. Same występy w śniadaniówkach czy posiadanie dużej firmy
to za mało – liczą się nagrody, publikacje i szerokie uznanie środowiska.
## Najczęstsze błędy i "pocałunek śmierci" dla artykułu
Unikaj tych błędów, jeśli nie chcesz, by Twój wpis zniknął w kilka minut:
* **Język marketingowy:** [Zwroty zwodnicze](https://pl.wikipedia.org/wiki/WP:WZ), typu "lider
branży", "najlepszy produkt", "eksperci uważają".
* **Błędy techniczne:** Błędne formatowanie, np. pogrubienia zamiast nagłówków.
* **Powtórzenia:** Każda informacja powinna być napisana tylko raz. Wikipedia to nie jest blog, czy
artykuł w czasopiśmie, gdzie trzeba przypominać co było wcześniej w artykule.
* **Brak deklaracji [WP:KI](https://pl.wikipedia.org/wiki/WP:KI):** Ukrywanie faktu otrzymania
wynagrodzenia za edycję.
* **Linki w treści** Linki mogą się znajdować tylko w sekcji linki zewnętrzne, jako przypisu oraz w
infoboksie.
## Reklama w Wikipedii – dlaczego to podejście jest ryzykowne?
Wielu przedsiębiorców błędnie zakłada, że skoro Wikipedia jest popularna, to stanowi idealne miejsce
na darmową promocję. Encyklopedia ta to nie jest platforma marketingowa, czy panorama firm. Dlatego
pod żadnym pozorem nie może służyć jako tablica ogłoszeniowa czy nośnik reklamowy. Próba uprawiania
działań typu **marketing w Wikipedii** spotyka się z natychmiastową i bardzo ostrą reakcją
społeczności.
* **Alergia na marketing:** Doświadczeni Wikipedyści są niezwykle wyczuleni na język korzyści.
Wszelkie przymiotniki wartościujące („nowoczesny”, „innowacyjny”, „unikalny”) działają na nich
jak płachta na byka i często skutkują nie tylko usunięciem treści, ale i zablokowaniem domeny.
* **Problem z obiektywizmem:** Marketing z natury dąży do podkreślania zalet, podczas gdy
Wikipedia wymaga suchego, encyklopedycznego zapisu faktów. Jeśli Twoim celem jest budowanie
pozytywnego wizerunku poprzez ukrywanie wad produktu, Wikipedia nie jest dla Ciebie.
* **Link building:** Próby dodawania linków do strony firmowej jako „źródeł” w niepowiązanych
tematycznie artykułach są traktowane jako spam i szybko trafiają na czarną listę.
Właśnie dlatego, aby uniknąć oskarżeń o spam i agresywny marketing, warto zlecić pisanie artykułu
profesjonalistom. Osoba z doświadczeniem wie, jak przekazać istotne fakty o firmie w sposób, który
spełnia standardy encyklopedyczne i nie budzi niechęci społeczności redaktorów.
## Dlaczego warto (lub nie warto) wynająć doświadczonego redaktora?
Samodzielna edycja często kończy się tzw. „spaloną ziemią” – zrażeniem administratorów i
zablokowaniem tematu na długi czas. Warto zastanowić się nad bilansem zysków i strat. Nauka zasad
Wikipedii to proces czasochłonny i żmudny. Jeśli Twoim celem jest stworzenie tylko jednego hasła
dla siebie lub swojej firmy, próba samodzielnego opanowania skomplikowanych reguł i technicznych
aspektów formatowania może okazać się zwyczajnie nieopłacalna. W takim przypadku znacznie prościej
i bezpieczniej jest zlecić edycję specjaliście.
Sytuacja zmienia się jednak, gdy pracujesz w agencji SEO, PR lub zajmujesz się budowaniem marek
osobistych (personal branding) i planujesz robić to zawodowo. Wówczas opanowanie zasad poprawnej
edycji staje się cenną kompetencją rynkową. Wiedza na ten temat jest co prawda publicznie dostępna,
ale mocno rozproszona po licznych stronach pomocy samej Wikipedii. Można również korzystać z
materiałów wideo, np. na [kanale YouTube stowarzyszenia Wikimedia
Polska](https://www.youtube.com/@wikimediapolska), jednak samodzielne składanie tych informacji w
całość zajmuje mnóstwo czasu.
Dla osób, które chcą pozyskać konkretną wiedzę w skondensowanej formie, idealnym rozwiązaniem jest
udział w profesjonalnym szkoleniu. Przykładem jest kurs organizowany przez WikiZEIT o nazwie
„[Wikipedia + SEO i nie tylko](/oferta.md)”, który w praktyczny sposób uczy, jak tworzyć trwałe i wartościowe
wpisy, unikając przy tym błędów prowadzących do ich usuwania.
Warto przy tym zaznaczyć istotne rozróżnienie: stowarzyszenie **Wikimedia Polska** również oferuje
darmowe szkolenia i warsztaty, jednak mają one charakter misyjny i są dedykowane konkretnym grupom,
takim jak **nauczyciele, bibliotekarze, uczniowie oraz studenci**. Ich celem jest szerzenie idei
wolnej wiedzy w edukacji i nauce. W przypadku firm, agencji PR, specjalistów SEO czy osób dbających
o wizerunek komercyjny, które muszą poruszać się w tematyce płatnych edycji, jedyną dedykowaną opcją
na polskim rynku pozostaje szkolenie **WikiZEIT**. Pozwala ono połączyć surowe zasady encyklopedii z
potrzebami nowoczesnego marketingu i budowania marki osobistej.
Doświadczony redaktor (lub przeszkolony pracownik):
* Potrafi obiektywnie ocenić szanse na przetrwanie wpisu przed rozpoczęciem prac.
* Zna techniczny język formatowania oraz biegle posługuje się mechanizmami społeczności.
* Wprowadza treści zgodnie z oficjalnymi procedurami (np. deklaracja
[WP:KI](https://pl.wikipedia.org/wiki/WP:KI)), co minimalizuje ryzyko szybkiego usunięcia
artykułu.
* Potrafi odpowiednio dobrać źródła, które zostaną zaakceptowane przez innych redaktorów.
## Kto zajmuje się płatną edycją Wikipedii w Polsce?
Na polskim rynku istnieje kilka głównych podmiotów i ścieżek:
* **WikiZEIT (Jakub T. Jankiewicz):** Specjalistyczne podejście, gdzie nacisk kładzie się na
kompletność wpisu i transparentność.
* **Soluma Interactive:** Agencja marketingowa oferująca pakiety edycyjne, w tym audyt i pisanie
haseł.
* **Green-fields:** Firma zajmująca się wizerunkiem, która w ofercie ma również Wikipedię.
* **Freelancerzy (UseMe/LinkedIn):** Można tam znaleźć osoby deklarujące pomoc, jednak ich
doświadczenie i znajomość aktualnych zasad bywają bardzo zróżnicowane.
## Ile kosztuje wpis w Wikipedii? Cennik i modele rozliczeń
Koszty zależą od skomplikowania tematu i renomy wykonawcy:
* **Modele godzinowe:** Przykładowo w **WikiZEIT** wstępna analiza jest darmowa, a koszt edycji to
obecnie do **300 zł za godzinę**. Średni czas przygotowania solidnego artykułu to około dwie
godziny pracy redaktora.
* **Modele pakietowe:** W **Soluma Interactive** sam audyt to koszt rzędu **440 zł**. Napisanie
artykułu kosztuje około **1000 zł**, przy czym dodatkowe elementy, jak zdjęcia czy infoboxy,
często są wyceniane jako osobne pozycje.
* **Ważne:** Żaden rzetelny redaktor nie zagwarantuje 100% pewności, że wpis pozostanie w
serwisie na zawsze, ponieważ ostateczna decyzja należy do społeczności administratorów.
## Jeśli nie Wikipedia to co?
Dla podmiotów, które nie spełniają surowych norm encyklopedyczności, idealnym rozwiązaniem są
projekty siostrzane:
* **Wikimedia Commons:** Tu możesz dodać zdjęcia firmowe, logo czy portrety CEO. Wymagana jest
zgoda fotografa i wolna licencja.
* **Wikidane:** To baza danych łącząca wszystkie projekty. Jest kluczowa dla Google i AI.
Zasady są tu mniej restrykcyjne niż w samej Wikipedii.
* **Synergia:** WikiZEIT oferuje łączenie tych usług – dodanie zdjęcia do Commons, wpisu do
Wikidanych i połączenie ich z Wikipedią buduje spójny „cyfrowy ślad” marki.
## Podsumowanie: Wikipedia to maraton, nie sprint
Obecność w Wikipedii to nie jednorazowa usługa marketingowa, ale proces dokumentowania realnych
osiągnięć. Skuteczna płatna edycja wymaga cierpliwości, doskonałych źródeł i pokory wobec zasad
społeczności. To prestiż, który stanowi ukoronowanie osiągnięć, a nie drogę do ich zdobycia.
---
### Czy Wikipedia jest płatna? Wikimedia Enterprise i SEO
## Czy Wikipedia jest płatna?
Dla normalnego użytkownika Wikipedia jest i zawsze będzie darmowa. Nie zawiera i raczej nie będzie
zawierać także także reklam. Jednak firmy takie jak Google czy Meta (dawny Facebook), które czerpią
z Wiki gigantyczne zyski, zaczęły płacić za profesjonalny dostęp do jej zasobów. Dane z Wikipedii w
dobie AI są na wagę złota.
Sprawdźmy, jak działa ten mechanizm.
## Co to jest Wikimedia Enterprise?
To komercyjna usługa API uruchomiona w 2021 roku. Skierowana jest do podmiotów operujących na
ogromną skalę. Firmy takie jak Google czy Microsoft nie muszą już
„[scrapować](https://en.wikipedia.org/wiki/Web_scraping)” stron. W zamian za opłaty otrzymują:
* **Dedykowany strumień:** Dane w czasie rzeczywistym.
* **Gwarancję SLA (Service Level Agreement):** Pewność dostępności systemów.
* **Format JSON:** Dane gotowe do użycia przez maszyny.
Co ciekawe w ramach Wikimedia Enterprise fundacja zapewnia także darmowy dostęp do API, które oferuje:
* 50,000 zapytań na miesiąc.
* 30 zapytań na miesiąc o kopie (zrzut) bazy (ang. Snapshot).
Limity te zostały zwiększone 2 czerwca 2026. Więcej na
[stronie projektu](https://enterprise.wikimedia.com/blog/enhanced-free-api/).
## Czy Fundacja Wikimedia zarabia na Wikipedii?
Tak, usługa **Wikimedia Enterprise** jest płatna. W roku fiskalnym 2023–2024 wygenerowała **3,4 mln
dolarów przychodu**.
* **Klienci:** Płacą m.in. Google, Meta i Perplexity.
* **Niezależność:** Przychody z Enterprise to ok. 2% budżetu Fundacji. Limit ustalono na 30%, aby
zachować niezależność od korporacji.
* **Misja:** Pieniądze wspierają serwery i edytorów.
## Kto płaci za Polską Wikipedię?
Polska Wikipedia utrzymuje się głównie z dobrowolnych wpłat. Kluczową rolę odgrywa tu
[Stowarzyszenie Wikimedia Polska](https://wikimedia.pl/), które posiada status Organizacji
Pożytku Publicznego (OPP).
Dzięki temu każdy podatnik w Polsce może przekazać **1,5% swojego podatku dochodowego** na wsparcie
wolnej wiedzy.
* **Finanse:** W budżecie Stowarzyszenia na 2024 rok wpływy z 1,5% zaplanowano na **1,4 mln zł**.
* **Udział:** Stanowi to niemal **połowę (ok. 45-50%)** całkowitych przychodów organizacji.
* **Cel:** Środki te finansują serwery, konkursy dla edytorów (np. Wiki Lubi Zabytki) oraz
szkolenia.
To prosta metoda wsparcia, która nie kosztuje Cię ani grosza, a realnie buduje polskie zasoby Wiki.
[Przekaż 1.5% podatku na Wikipedię już dziś](https://opp.wikimedia.pl/).
## Perspektywa SEO: Wikipedia jako fundament
Dla specjalistów SEO Enterprise to jasny sygnał:
1. **[Knowledge Graph](/tools/graf-wiedzy/):** Google jeszcze szybciej integruje dane w wynikach wyszukiwania.
2. **Paliwo dla AI:** Modele LLM (jak GPT-4) karmią się tymi danymi. Jakość treści na Wiki wpływa na
to, co AI mówi o Twojej marce.
3. **Szybkość:** Zmiany w artykułach trafiają do wyszukiwarek niemal natychmiast (real-time).
4. **[Autorytet (E-E-A-T)](/blog/widoczonosc-marki-osobistej-w-ai/#co-to-jest-e-e-a-t%3F):** Wikipedia to główny punkt weryfikacji powiązań między bytami w sieci.
## Szybkość, która zaskakuje: Google vs EK
Ciekawostką jest niesamowita szybkość, z jaką Google reaguje na zmiany. Obserwacje pokazują, że nowe
strony są indeksowane w ciągu zaledwie kilku minut.
Dzieje się to tak szybko, że nawet gdy artykuł zostaje niemal natychmiast skasowany przez
administratorów (tzw. EK – ekspresowe kasowanie), Google często zdąży już pobrać jego treść.
To pokazuje różnicę między dawnym „czekaniem na bota” a obecnym strumieniem danych live. Dla SEO to
dowód, że Google traktuje ekosystem Wiki jako priorytetowe źródło informacji, któremu ufa
bezgranicznie.
## Nie tylko Wikipedia, czyli projekty siostrzane
Wikimedia Enterprise to nie tylko teksty z Wikipedii. Usługa agreguje dane z całego ekosystemu, co
ma kluczowe znaczenie dla nowoczesnego internetu:
* **[Wikidane (Wikidata)](/blog/czym-sa-wikidane.md):** To serce usługi. Dostarcza ponad 120 mln ustrukturyzowanych obiektów. To
stąd Google czerpie fakty (daty, liczby, powiązania) do paneli wiedzy (Knowledge Panels).
* **Wikimedia Commons:** API dostarcza bezpośrednie linki do mediów oraz precyzyjne dane o
licencjach. Dzięki temu giganci mogą legalnie wyświetlać zdjęcia przy zachowaniu praw autorskich
autorów.
* **Inne projekty:** Usługa obejmuje też Wikisłownik czy Wikitravel, tworząc kompletny obraz wiedzy
dostępny w jednym, szybkim strumieniu danych.
Dla SEO oznacza to, że optymalizacja pod graf wiedzy wymaga dziś dbania nie tylko o treść artykułu,
ale też o dane strukturalne w Wikidanych.
## Wikidane: Real-time dla Grafu Wiedzy
Powszechnie uważa się, że na zmiany w Grafie Wiedzy (ten boks po prawej w Google) czeka się
miesiącami. To prawda w przypadku tradycyjnych metod, ale Wikimedia Enterprise zmienia zasady gry.
Usługa udostępnia **Wikidane w czasie rzeczywistym** (API Realtime). Oznacza to, że każda edycja
strukturalna trafia do gigantów IT w milisekundach.
Dlaczego warto dbać o Wikidane już teraz?
* **Paliwo dla AI:** Modele językowe nie czytają tylko tekstu – one analizują relacje. Wikidane to
dla nich najczystsza forma wiedzy.
* **Skracanie kolejek:** Posiadanie ustrukturyzowanego wpisu w Wikidanych to najszybsza droga do
„zrozumienia” Twojej marki przez algorytmy Google.
* **Większy zasięg:** Dane z Wikidanych zasilają nie tylko Google, ale też asystentów głosowych
(Siri, Alexa) i tysiące aplikacji zewnętrznych.
Nawet jeśli Google potrzebuje czasu na weryfikację i wyświetlenie danych w Grafie Wiedzy, dzięki
Enterprise dostaje je natychmiast. To fundament Twojego E-E-A-T.
## Identyfikatory: Klucz do Twojego autorytetu
W Wikidanych istnieje sekcja „Identyfikatory”. To tam znajdują się linki do profili na LinkedIn,
Twitterze, bazach naukowych czy branżowych.
Dla Google to najważniejszy drogowskaz:
* **Łączenie kropek:** Enterprise przesyła te linki jako twarde dowody, że „Twoja Marka” na LinkedIn
to ten sam podmiot, co w Wikipedii.
* **Budowa E-E-A-T:** To najskuteczniejszy sposób na potwierdzenie swojej wiarygodności w oczach
algorytmu.
Dbanie o te powiązania w Wikidanych to obecnie jedna z najbardziej niedocenianych strategii SEO
technicznego.
## Pro TIP: Łącz dane z Schema.org
Pamiętaj, że dane z Wiki najlepiej działają w parze z Twoją stroną. Używając właściwości `sameAs` w
kodzie Schema.org, możesz wprost wskazać Google swój profil w Wikidanych. Więcej o tym przeczytasz
wkrótce w artykule:
[„Dane strukturalne Schema.org – przewodnik dla początkujących”](/blog/dane-strukturalne-schema-org.md).
## Strategiczny link w stopce
Mało kto to robi, a warto: dodaj link do swojego wpisu w Wikidanych w stopce strony. W połączeniu z
danymi strukturalnymi tworzy to „cyfrowy dowód tożsamości”. Pomagasz Google szybciej i pewniej
połączyć Twoją witrynę z oficjalną encją w Grafie Wiedzy.
## Podsumowanie
Wikimedia Enterprise to uczciwy układ. Giganci budujący biznesy na pracy wolontariuszy w końcu płacą
za infrastrukturę. Dla SEO to dowód, że Wikipedia oraz Wikidane pozostają „kręgosłupem” internetu.
---
Źródła użyte w artykule:
* [Oficjalna strona Wikimedia Enterprise](https://enterprise.wikimedia.com/)
* [Raport finansowy Fundacji (WMF)](https://diff.wikimedia.org/2025/11/24/wikimedia-enterprise-financial-report-fiscal-year-2024-2025/)
* [News: Giganci AI płacą za dane](https://itreseller.pl/giganci-ai-zaplaca-za-wiedze-wikimedia-foundation-oglasza-umowy-z-perplexity-microsoftem-i-meta/)
* [Wikidata APIs from Wikimedia Enterprise: Connect to the World’s Knowledge Graph](https://enterprise.wikimedia.com/blog/wikidata-api-endpoints-wikimedia-enterprise/)
---
### Baby Globe: czyli nowa maskotka Wikipedii
Z okazji 25-lecia Wikipedii powstała nowa maskotka o nazwie
[„Baby Globe”](https://wikimediafoundation.org/wikipedia25/wikipedia-mascot/).

Wikimedia Foundation staff and contractors; [CC BY-SA 4.0](https://creativecommons.org/licenses/by-sa/4.0); źródło [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Neutral_Baby_Globe.gif)
## Jak powstała nowa maskotka Wikipedii?
Autorem pomysłu ikony jest Jonathan Ferreira, w projektach Wikimedów znany jako
[BaduFerreira](https://en.wikipedia.org/wiki/User:BaduFerreira). Pierwotnie maskotka powstała jako szkic
wykonany w pociągu. Następnie, pomysł Jonathana, został rozwinięty przez pracowników fundacji Wikimedia. Tak powstała nowa maskotka Wikipedii.
Szczegóły powstania maskotki można poznać w [wywiadzie z Jonathanem w portalu Diff fundacji
Wikimedia](https://diff.wikimedia.org/2026/01/15/meet-the-wikimedian-whose-casual-sketch-inspired-wikipedias-25th-birthday-mascot/).
## Maskotka Wikipedii jako pluszak
Powstała także wersja maskotki, którą można przytulać. Dostępna w
[przedsprzedaży](https://www.makeship.com/products/baby-globe-plushie) (wysyłka w lipcu 2026).

Designed and produced by Makeship with the Wikimedia Foundation
based on an illustration from User:BaduFerreira, [CC BY-SA 4.0](https://creativecommons.org/licenses/by-sa/4.0); [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Baby_Globe_plushie_Wikipedia_25th_birthday_mascot.jpg)
## Maskotka Wikimedia Commons
Warto powiedzieć, że istnieje także maskotka [Wikimedia
Commons](https://pl.wikipedia.org/wiki/Wikimedia_Commons) (czyli zasobów medialnych Wikipedii i
projektów siostrzanych) o nazwie [„Puzzly”](https://commons.wikimedia.org/wiki/Category:Puzzly).

Wikimedia Foundation; [CC BY-SA 3.0](https://creativecommons.org/licenses/by-sa/3.0); [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Puzzly_(RTL).svg)
Maskotka jest głównie używana w materiałach i przewodnikach po prawie autorskim oraz [licencjach
Creative Commons](https://pl.wikipedia.org/wiki/Licencje_Creative_Commons) dostępnych na Wikimedia
Commons. Przykładem może być infografika dostępna przy dodawaniu zdjęć oraz innych multimediów. Istnieją różne wersje
językowe przewodnika, poniżej wersja polska.

Wersja Angielska Wikimedia Foundation;
Translation by [Masur](https://commons.wikimedia.org/wiki/User:Masur);
Localization by [Otourly](https://commons.wikimedia.org/wiki/User:Otourly)
[CC BY-SA 3.0](https://creativecommons.org/licenses/by-sa/3.0) [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Licensing_tutorial_pl.svg)
## Personifikacja Wikipedii
Oprócz maskotek warto także wspomnieć o [Wikipe-tan](https://pl.wikipedia.org/wiki/Wikipedia:Wikipe-tan).
Jest to nieoficjalna personifikacja Wikipedii, w stylu anime, stworzona przez Japońskiego Wikipedystę o nicku Kasuga.

Kasuga, and Editor at Large; [CC BY-SA 3.0](http://creativecommons.org/licenses/by-sa/3.0/); [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Wikipe-tan_full_length.svg)
---
### Encyklopedyczność firm i osób: zasady polskiej Wikipedii?
Polska Wikipedia ma wiele zasad wypracowanych przez lata przez społeczność Wikipedystów. Są one
jednak porozrzucane w historii tzw. DNU, czyli poczekalni, gdzie toczą się dyskusje nad
encyklopedycznością konkretnych artykułów.
W tym artykule przedstawię, jak wygląda rzeczywistość zasad encyklopedyczności w polskiej
Wikipedii. Czyli czy twój temat nadaje się do Wikipedii?
## Kryteria encyklopedyczności
Najważniejszą strona w Wikipedii to
[WP:WER](https://pl.wikipedia.org/wiki/Wikipedia:Encyklopedyczno%C5%9B%C4%87). Czyli zbiór zasad,
które zostały zaakceptowane przez społeczność Wikipedystów. Jedna z nich jest np. to, że doktorzy
habilitowani są autoencyklopedyczni, czyli wystarczy, że naukowiec posiada habilitację i już automatycznie
nadaje się do Wikipedii.
Obowiązujące kryteria można znaleźć na powyższej stronie w sekcji "Kryteria – obowiązujące".
## Propozycje kryteriów
Istnieje także [kategoria z propozycjami kryteriów](https://pl.wikipedia.org/wiki/Kategoria:Propozycje_kryteri%C3%B3w_encyklopedyczno%C5%9Bci).
Jedną z nich jest [propozycja kryteriów dotycząca przedsiębiorstw](https://pl.wikipedia.org/wiki/Wikipedia:Propozycje_kryteri%C3%B3w_encyklopedyczno%C5%9Bci/Przedsi%C4%99biorstwa).
## Jakie są zasady encyklopedyczności firm?
Jest to oczywiście propozycja, ale można się na nią powoływać, gdy ktoś zakwestionuje
encyklopedyczność waszej strony, zgłaszając ją do DNU (tj. Dyskusji Nad Usunięciem).
Najważniejsze przesłanki encyklopedyczności, czyli czy firma nadaje się do Wikipedii:
* zatrudnienie na poziomie co najmniej 250 pełnoetatowych pracowników,
* roczne przychody na poziomie co najmniej 50 milionów EUR,
* akcje spółki notowane są na „uznanej giełdzie” – w Polsce na rynku regulowanym Giełdy Papierów
Wartościowych,
* jedna z wiodących pozycji pod względem udziału w rynku (potwierdzone przez niezależnymi źródłami),
* rozpoznawalna marka,
* wyróżnianie się szczególną innowacyjnością
* uznanie w postaci przyznanych znaczących nagród lub wyróżnień branżowych,
* stanowi z innych weryfikowalnych względów ważny element gospodarki, infrastruktury lub kultury
regionu czy państwa lub też wniosło istotny wkład w historię branży lub regionu
(np. przedsiębiorstwa użyteczności publicznej, spółdzielnie o istotnym znaczeniu społecznym itp.),
o czym świadczą wiarygodne źródła;
* lub też spełniało ww. przesłanki w przeszłości.
To są oczywiście przesłanki, ale im więcej z powyższych punktów firma spełnia, tym większa szansa na
encyklopedyczność i zostanie w Wikipedii.
## Czego nie robić dodając artykuł o firmie do Wikipedii?
Wikipedia nie jest medium reklamowym ani katalogiem firm. Więc treści czysto reklamowe,
niepotwierdzone wiarygodnymi, niezależnymi, źródłami, bardzo szybko zostaną skasowane.
Jeśli jedyne wzmianki o firmie to strony sponsorowane i komunikaty firmy oraz działania firm SEO, są
niewielkie szanse na encyklopedyczność. Więc dodawanie strony takiej firmy po prostu nie ma sensu i
jest to tylko strata czasu i pieniędzy.
## DNU, czyli poczekalnia
DNU (czyli Dyskusja nad usunięciem) to system używany w polskiej Wikipedii, służący dyskusji na
temat encyklopedyczności artykułów. Każdy Wikipedysta może zgłosić artykuł do DNU. Wikipedia opiera
się na [konsensusie](https://pl.wikipedia.org/wiki/Wikipedia:Konsensus). Każdy może wziąć udział w
dyskusji DNU, jednak liczą się merytoryczne argumenty nie ilość głosów.
Polska Wikipedia działa trochę jak system [precedensów](https://pl.wikipedia.org/wiki/Precedens) w
prawie USA. Można powoływać się na inne dyskusje w DNU, gdzie po dyskusji artykuł został w
Wikipedii lub został skasowany. Można także powoływać się na kryteria lub ich propozycje.
Aby przeszukać DNU, w celu zebrania przykładów, można posłużyć się
[zaawansowaną wyszukiwarką](https://pl.wikipedia.org/w/index.php?search=poczekalnia&title=Specjalna%3ASzukaj&profile=advanced&fulltext=1&ns4=1).
Powyższy link otworzy wyszukiwarkę Wikipedii z hasłem "poczekalnia" oraz wybraną przestrzenią
"Wikipedia:". Wystarczy dodać to, co nas interesuje, np. czy firma na giełdzie GWP, ale rynku
[NewConnect](https://pl.wikipedia.org/wiki/NewConnect), może świadczyć o ency. W tym celu wystarczy
dodać NewConnect do zapytania.
## Esej o auto encyklopedyczności
Był to projekt, jednego z Wikipedystów, w celu zebrania wszystkich historycznych argumentów na temat
encyklopedyczności tematów w Wikipedii.
[Strona eseju](https://pl.wikipedia.org/w/index.php?title=Wikipedysta:Nedops/Esej_o_przes%C5%82ankach_autoencyklopedyczno%C5%9Bci&redirect=no)
aktualnie jest przekierowaniem, ponieważ w kwietniu 2026 powstała nowa inicjatywa.
## Wikiprojekt:Encyklopedyczność
[Wikiprojekt
Encyklopedyczność](https://pl.wikipedia.org/wiki/Wikiprojekt:Encyklopedyczno%C5%9B%C4%87), to nowy
projekt w polskiej Wikipedii, którego celem jest usystematyzowanie podejścia do możliwości
opisywania poszczególnych tematów i zagadnień na polskojęzycznej Wikipedii.
Miejmy nadzieję, że dzięki tej inicjatywie zasady encyklopedyczności będą bardziej klarowne.
## Czy twoja firma może mieć stronę w Wikipedii?
Jeśli nadal zastanawiasz się, czy twoja firma nadaje się do Wikipedii. Wykonam dla ciebie darmowy
audyt, sprawdź szczegóły na stronie z [moją ofertą](https://wikizeit.edu.pl/oferta.md).
---
### Kto w Polsce prowadzi szkolenia z edytowania Wikipedii?
Każdy może edytować Wikipedię. Nie trzeba być nawet zalogowanym, ale dodawanie treści, które spełnia
wymogi Wikipedii, wypracowane przez jej społeczność, jest wyzwaniem, szczególnie gdy zaczyna się
edycje. Dodanie pojedynczego artykułu można zlecić innym, jednak gdy chce się dodawać treści
sukcesywnie, warto skorzystać z dedykowanych szkoleń z Wikipedii.
W poniższym artykule przedstawiam rzetelny przegląd dostępnych możliwości nauki – od darmowych
warsztatów społecznościowych, po profesjonalne szkolenia komercyjne dla firm.
## Kto prowadzi szkolenia z edytowania Wikipedii w Polsce?
W Polsce jest kilka miejsc, gdzie można w zorganizowany sposób nauczyć się edycji Wikipedii.
1. **Stowarzyszenie Wikimedia Polska** – jest organizacją pożytku publicznego, która jest partnerem
Wikimedia Foundation na Polskę. Stowarzyszenie WMPL organizuje szkolenia, które prowadzą
wolontariusze tworzący grupę
[WikiTrenerów](https://pl.wikipedia.org/wiki/Wikipedia:WikiTrenerzy).
* WMPL prowadzi szkolenia w ramach [Wiki Szkoły](https://wikiszkola.pl/szkolenia/)
* Jednym z większych projektów edukacyjnych jest [Wikiteka](https://wikiszkola.pl/wikiteka/),
przeznaczona dla bibliotekarek/bibliotekarzy i od niedawna także nauczycieli.
* Oferta WMPL jest skierowana głównie do osób związanych z edukacją w tym uczniów i studentów.
* [Akademia Wikimediów](https://wikimedia.pl/akademia-wikimediow/) jest to jeszcze jeden projekt
Edukacyjny WMPL. Do projektu mogą się także zapisać pojedyncze osoby niezwiązane z edukacją.
3. **WikiZEIT** – prowadzi [komercyjne szkolenia z edytowania Wikipedii i projektów
siostrzanych](https://wikizeit.edu.pl/oferta.md). Aktualnie jest to jedyna na rynku opcja
płatnych szkoleń z Wikipedii w Polsce. Szkolenia prowadzone są przez [Jakuba
T. Jankiewicza](https://jakub.jankiewicz.org/pl/), doświadczonego redaktora, przewodnika oraz
WikiTrenera Polskiej Wikipedii, który prowadzi także szkolenia jako wolontariusz dla
Stowarzyszenia Wikimedia Polska.
3. **NobleProg** – oferuje szkolenia techniczne z oprogramowania
[MediaWiki](https://www.mediawiki.org/wiki/MediaWiki). MediaWiki to projekt Open Source, który
jest silnikiem, na którym stoją wszystkie projekty Wikimediów (tj. Wikipedia, Wikimedia Commons,
czy Wikidane). Warto podkreślić, że szkolenia NobleProg **nie dotyczą zasad edytowania
Wikipedii**, lecz administracji systemem informatycznym, na którym ona działa. Dedykowane jest
osobom i formom, które chcą tworzyć własne Wiki.
## Inne inicjatywy i kursy edukacyjne w Polsce
Wikimedia Polska organizuje także pojedyncze wydarzenia, jak np. [Kurs webinarowy: Wikipedia od A do
Z. Mój pierwszy artykuł w
Wikipedii](https://etwinning.pl/aktualnosci/kurs-webinarowy-wikipedia-od-a-do-z-moj-pierwszy-artykul-w-wikipedii)
z 2024 roku. Organizowany wspólnie z [FRSE](https://www.frse.org.pl/).
W Październiku 2025 odbyło się szkolenie w ramach projektu GLAM (ang. galleries, libraries, archives, and museums) „[jak skutecznie zwiększać obecność zbiorów muzealnych online](https://nim.gov.pl/aktualnosci/szkolenie-wikipedia-i-projekty-glam-wiki-jak-skutecznie-zwiekszac-obecnosc-zbiorow-muzealnych-online.html)”.
## Materiały edukacyjne
Na [kanale YouTube stowarzyszenia](https://www.youtube.com/@wikimediapolska) można znaleźć materiały
edukacyjne:
* [Wikipedia bez tajemnic](https://www.youtube.com/playlist?list=PLGthWZtDb6-DHIW8O1CtQzhUWy50KcFra).
* [Edytowanie Wikipedii - krok po
kroku](https://www.youtube.com/playlist?list=PLGthWZtDb6-C7dy_6nip-JP25mD0FTlAj).
* [Akademia Wikimedia - Poznaj świat
Wikipedii](https://www.youtube.com/playlist?list=PLGthWZtDb6-B19eEcOV2M7ARUhiIziI1E).
* [Jak korzystać ze zdjęć w Wikimedia Commons? Prawa autorskie w Wikimedia Commons -
szkolenie](https://www.youtube.com/watch?v=0lZabu5IUWs).
* [Co to są Wikidane - wprowadzenie dla początkujących - styczeń
2024](https://www.youtube.com/watch?v=o1cYXBp_2B8).
* [Wikidane dla zupełnie początkujących](https://www.youtube.com/watch?v=CWa0nX4abGA).
## Edytowanie komercyjne i współpraca z agencjami SEO
Specyficznym wyzwaniem jest edytowanie Wikipedii w celach komercyjnych (tzw. *Paid Editing* - płatna
edycja). Oficjalne szkolenia stowarzyszeń koncentrują się na misji wolontariackiej i
edukacyjnej. Jednak firmy, instytucje czy agencje SEO/GEO/AEO/AIO często potrzebują wiedzy, jak
zgodnie z rygorystycznymi zasadami Wikipedii oraz Warunkami Użytkowania Wikimedia Foundation
deklarować odpłatną edycję.
Jeśli Twoja firma lub agencja planuje wprowadzenie treści komercyjnych do Wikipedii, warto
skonsultować się z ekspertem. W ramach WikiZEIT oferuję wsparcie w procesie poprawnej deklaracji
odpłatności oraz weryfikacji encyklopedyczności materiałów, co pozwala uniknąć blokad kont i
natychmiastowego usuwania artykułów.
## Podsumowanie
Jeśli interesuje cię wprowadzenie do Wikipedii, warto zacząć od kanału YouTube stowarzyszenia. Jeśli
interesuje cię szkolenie na żywo, możesz wybrać Stowarzyszenie Wikimedia Polska. Osobą odpowiedzialną
za edukacje w stowarzyszeniu jest [Wioletta
Matusiak](https://pl.wikimedia.org/wiki/U%C5%BCytkowniczka:Wioletta_Matusiak_(WMPL)).
Jeśli interesuje cię kompleksowe szkolenie z edycji Wikipedii, Wikidanych, oraz Wikimedia Commons, dla firm i instytucji
możesz skorzystać z [oferty WikiZEIT](https://wikizeit.edu.pl/oferta.md).
---
### Dane strukturalne Schema.org – przewodnik dla początkujących
Dane strukturalne (structured data) to sposób na opisanie treści strony internetowej w formacie
zrozumiałym dla wyszukiwarek. Schema.org to najczęściej używany słownik do tworzenia danych
strukturalnych, wspierany przez Google, Microsoft, Yahoo i Yandex.
## Czym są dane strukturalne?
Dane strukturalne to dodatkowe informacje umieszczone w kodzie HTML strony, które pomagają
wyszukiwarkom zrozumieć kontekst treści. Dzięki nim wyszukiwarki mogą wyświetlać **rozszerzone
wyniki** (rich results), takie jak:
- Gwiazdki ocen produktów
- Czas przygotowania przepisów
- Daty i lokalizacje wydarzeń
- Panele wiedzy o organizacjach
### Dane strukturalne a Semantic Web (Sieć Semantyczna)
Wdrożenie danych strukturalnych to praktyczny krok w stronę realizacji wizji [Semantic
Web](https://pl.wikipedia.org/wiki/Sie%C4%87_semantyczna). Jest to koncepcja „inteligentnego
internetu” stworzona przez Tima Bernersa-Lee, w której maszyny nie tylko wyświetlają tekst, ale
realnie rozumieją jego znaczenie i powiązania.
Stosując ustandaryzowany słownik [Schema.org](https://schema.org/), zmieniasz swoją stronę z
prostego dokumentu w element globalnej sieci danych:
* **Od słów do encji:** Wyszukiwarka przestaje widzieć tylko ciąg liter (np. „Jaguar”), a zaczyna
rozpoznawać konkretny obiekt (samochód, zwierzę lub system).
* **Łączenie faktów:** Dane o autorze, dacie publikacji i temacie wpisu tworzą logiczne powiązania,
które zasilają bazy wiedzy, takie jak Google Knowledge Graph.
* **Fundament dla AI:** Ustrukturyzowane informacje są kluczowe dla asystentów głosowych i modeli
AI, które potrzebują precyzyjnych danych do generowania trafnych odpowiedzi.
## Format JSON-LD
Google rekomenduje format **JSON-LD** (JavaScript Object Notation for Linked Data) jako preferowany sposób wdrożenia danych strukturalnych:
```json
{
"@context": "https://schema.org",
"@type": "Organization",
"name": "WikiZEIT",
"url": "https://wikizeit.edu.pl/",
"logo": "https://wikizeit.edu.pl/img/logo.svg",
"description": "Projekt edukacyjny o Wikipedii i etycznym SEO"
}
```
JSON-LD jest wygodny, ponieważ:
1. Umieszczany jest w tagu `
 ### Jestem WikiTrenerem
 ### Jestem WikiTrenerką
 ## Link do Commons
Link do [kategorii z grafikami na Wikimedia Commons](https://commons.wikimedia.org/wiki/Category:Jestem_w_Wikipedii).
---
### Dokumentacja Eksponatów w Muzeum 'Domek Tkaczki'
W pierwszej połowie czerwca 2026 wykonałem sesję fotograficzną, dokumentującą eksponaty w [Muzeum
Dawnej Wsi „Domek Tkaczki”](https://www.domektkaczki.pl/).

Jakub T. Jankiewicz wykonujący zdjęcie, fot. [Urszula Wolska](https://wolska.jcubic.pl), Wszystkie prawa zastrzeżone
## Zdjęcia eksponatów z Domku Tkaczki
Przykładowe zdjęcia wykonane aparatem Fuji X-Pro 3.
### Czółenko

Czółenko, fot. [Jakub T. Jankiewicz](https://jakub.jankiewicz.org/), licencja: [CC-BY-SA](https://creativecommons.org/licenses/by-sa/4.0/)
### Drewniana Piasta

Drewniana Piasta, fot. [Jakub T. Jankiewicz](https://jakub.jankiewicz.org/), licencja: [CC-BY-SA](https://creativecommons.org/licenses/by-sa/4.0/)
### Strug

Strug, fot. [Jakub T. Jankiewicz](https://jakub.jankiewicz.org/), licencja: [CC-BY-SA](https://creativecommons.org/licenses/by-sa/4.0/)
Więcej zdjęć z sesji na Wikimedia Commons w kategorii: [Collections of Muzeum Dawnej Wsi Domek Tkaczki](https://commons.wikimedia.org/wiki/Category:Collections_of_Muzeum_Dawnej_Wsi_Domek_Tkaczki).
---
### Jak napisać bota do Wikipedii
## Co takiego jest bot?
Bot jest to specjalny program komputerowy, który używa dodatkowego konta jakiegoś
[Wikipedysty](https://pl.wikipedia.org/wiki/Społeczność_wikipedystów).
Taki program może wykonywać różne automatyczne działania w Wikipedii, najczęściej jakieś
automatyzacje np. globalne poprawki w artykułach lub jakieś konkretne działania edycyjne.
W tym artykule opiszę jak stworzyć prostego bota przy użyciu języka programowania
[Python](https://pl.wikipedia.org/wiki/Python).
## Instalacja Pythona
Pierwsza rzecz to instalacja Pythona, najlepiej jest wyszukać w Google "jak zainstalować pythona"
oraz nasz system operacyjny. Instalacja będzie się różnić między Windowsem, MacOS oraz Linux.
Pod systemami Linux dodatkowo należy zainstalować [PIP](https://pl.wikipedia.org/wiki/Pip_(menadżer_pakietów)),
czyli manager paczek Pythona.
## Biblioteka pywikibot
Po instalacji Pythona i PIP należy zainstalować paczkę `pywikibot` jest to biblioteka,
za pomocą której można automatyzować działania w Wikipedii. W tym celu w terminalu należy wynikać polecenie:
```bash
pip install pywikibot
```
### Dlaczego warto korzystać z pywikibot?
[API](https://pl.wikipedia.org/wiki/Interfejs_programowania_aplikacji)
[MediaWiki](https://pl.wikipedia.org/wiki/MediaWiki) (silnika napędzającego Wikipedię) jest bardzo rygorystyczne. Jednym z kluczowych
wymogów bezpieczeństwa jest przesyłanie unikalnego i poprawnego nagłówka
[User-Agent](https://pl.wikipedia.org/wiki/User_agent) przy każdym
zapytaniu [HTTP](https://pl.wikipedia.org/wiki/HTTP). Dzięki temu administratorzy wiedzą, jaki bot generuje ruch.
Wielką zaletą pywikibot jest to, że obsługuje nagłówek User-Agent w pełni automatycznie. Framework
sam generuje go na podstawie Twojego pliku konfiguracyjnego, łącząc nazwę bota z wersją
biblioteki. Dzięki temu nie musisz ręcznie konfigurować sesji HTTP ani martwić się o niespodziewane
blokady adresu IP ze strony serwerów Wikimedia.
Drugą rzeczą jest [rate limit](https://en.wikipedia.org/wiki/Rate_limiting), które biblioteka ogarnia.
## Tworzenie hasła dla bota
Korzystając z biblioteki `pywikibot`, można zalogować się do swojego konta za pomocą
hasła do Wikipedii, ale w przypadku botów, nie jest do za bardzo bezpieczne.
A gdy, tak jak w moim przypadku, masz ustawione
[podwójne uwierzytelnianie](https://pl.wikipedia.org/wiki/Uwierzytelnianie_wieloskładnikowe),
nie będzie to możliwe.
Dlatego w Wikipedii jest możliwość stworzenia specjalnego hasła dla bota.
Coś podobnego do [API Key](https://en.wikipedia.org/wiki/API_key) w różnego rodzaju usługach.
Wchodzimy na stronę: [Specjalna:Hasła_botów](https://pl.wikipedia.org/wiki/Specjalna:Hasła_botów)
i dodajemy nowe hasło:

formularz dodawania hasła bota
klikamy „utwórz” i wybieramy uprawnienia:

uprawnienia bota z zaznaczonymi uprawnieniami do edycji i tworzenia stron
Po wybraniu uprawnień dodawania i edycji stron, na dole strony klikamy „utwórz”:

nowe wygenerowane hasło bota
Po utworzeniu powinno się pojawić losowe hasło, zapisz je sobie, będziemy go używać za chwilę.
## Bot Hello World przez API
Najprostsze użycie biblioteki pywikibot, która doda nową stronę do Wikipedii w twojej przestrzeni
użytkownika wygląda tak.
```python
import pywikibot
def main():
# 1. Inicjalizacja połączenia z polską Wikipedią (używa user-config.py)
site = pywikibot.Site('pl', 'wikipedia')
# 2. Wskazanie konkretnej strony w Twoim brudnopisie
page = pywikibot.Page(site, 'Wikipedysta:Jcubic/HelloBot')
# 3. skrypt
if page.exists():
print("Błąd: Podana strona testowa już istnieje!")
return
# 4. Dodanie nowego tekstu
page.text = "Witaj, Wikipedio!"
# 5. Zapisanie zmodyfikowanej strony z opisem zmian
page.save(
summary="[WikiZEIT Test] Pierwsze uruchomienie bota Hello World przez API",
minor=True
)
print("Sukces! Strona została utworzona.")
if __name__ == '__main__':
main()
```
* `pywikibot.Site()` - zwraca obiekt. który umożliwia dostęp do danego projektu.
* `pywikibot.Page()` - zwraca obiekt konkretnej strony, strona nie musi istnieć.
* `page.exists()` - sprawdza, czy strona istnieje.
* `page.text` - to accessor, który zawiera tekst strony.
* `page.save()` - zapisuje stronę.
## Logowanie do Wikipedii
Aby nasz bot mógł się zalogować do Wikipedii należy utworzyć plik `user-config.py`
Jego zawartość powinna wyglądać tak:
```python
family = 'wikipedia'
mylang = 'pl'
usernames['wikipedia']['pl'] = 'jcubic' # tutaj wstaw swój nick
password_file = 'user-password.py'
```
Plik `user-password.py` powinien zawierać krotkę, która wygląda tak:
```python
('Jcubic', BotPassword('Hello-World', 'r4qli70elje53e48s8lqf4oddnmrjjer'))
```
Oczywiście musisz wpisać swoje własne hasło bota.
Teraz możemy uruchomić nasz skrypt, wynikiem powinno być coś takiego:
```text
Logging in to wikipedia:pl as Jcubic@Hello-World
Sleeping for 7.4 seconds, 2026-06-07 21:52:31
Page [[Wikipedysta:Jcubic/HelloBot]] saved
Sukces! Strona została utworzona.
```
Wchodzą na Wikipedię i zaglądając do naszych edycji na stronie
[Specjalna:Wkład/Jcubic](https://pl.wikipedia.org/wiki/SSpecjalna:Wkład/Jcubic),
widzimy edycje bota:

historia edycji z opisem "\[WikiZEIT Test] Pierwsze uruchomienie bota Hello World przez API"
A wchodzą na stronę w naszej przestrzeni nazw możemy zobaczyć nasz tekst:

strona Wikipedysta:Jcubic/HelloBot z tekstem Witaj, Wikipedio!
## Rejestracja konta bota
Jeśli zamierzasz stworzyć prawdziwego bota, musisz zarejestrować nowe konto dla niego.
Jeśli nie chcesz wylogowywać się z Wikipedii, możesz zrobić to w oknie incognito lub
otworzyć inną przeglądarkę.
Po założeniu konta, na stronie użytkownika, musimy wpisać informacje że jest to konto bota:

Kod strony użytkownika bota Wikipedysta:WikiZEITBot z opisem jego działania
Powyższy opis dotyczy mojego bota, którego zacząłem tworzyć razem podczas pisania tego artykułu.
Tak wygląda zapisana strona:

Wynikowa zapisana strona z banerem, na początku który mówi, że jest to konto bota
Najważniejsze jest dodanie szablonu
{% raw %}
```text
{{Szablon:Bot|Jcubic}}
```
{% endraw %}
Aby poinformować, że jest to bot.
## Legalizacja bota
Następnym wymaganym krokiem jest zgłoszenie naszego bota na stronie
[Wikipedia:Boty/Zgłoszenia](https://pl.wikipedia.org/wiki/Wikipedia:Boty/Zgłoszenia).
Dzięki temu jeden z [Biurokratów](https://pl.wikipedia.org/wiki/Wikipedia:Biurokraci),
doda nam flagi, dzięki którym będziemy mogli używać bota legalnie.
Na stronie ze zgłoszeniami należy kliknąć złóż wniosek:

Instrukcja jak złożyć wniosek dotyczący bota
Wypełnić formularz:

formularz jako kod wiki
Tak wyglądał mój wniosek:

Wynikowy wypełniony formularz z oznaczeniem nowy
Warto obserwować [stronę z wnioskami](https://pl.wikipedia.org/wiki/Wikipedia:Boty/Zgłoszenia/Wnioski)
oraz mieć włączone powiadomienia email, gdy obserwowana strona się zmieni.
## Co dalej?
Następny krokiem jest napisanie kodu bota, który zrealizuje cel, jaki chcemy osiągnąć. Moim celem
jest pomoc przewodnikom w monitorowaniu swoich podopiecznych.
### Czym jest Wikimedia Toolforge?
Dobrze jest także uniezależnić bota od własnego komputera. Wikimedia udostępnia specjalne
środowisko chmurowe o nazwie Toolforge. Jego celem jest utrzymywanie narzędzi, które pomagają w
edycji projektów Wikimediów.
Dzięki temu nasz bot może działać nawet, jak nasz komputer nie jest włączony.
## Podsumowanie
Boty to potężne narzędzia, które potrafią w kilka sekund wykonać pracę wymagającą od człowieka wielu
dni żmudnego klikania. Należy pamiętać o słowach mędrca: „[With great power comes great
responsibility](https://en.wikipedia.org/wiki/With_great_power_comes_great_responsibility)”. Automatyzacja
edycji na żywym organizmie, jakim jest Wikipedia, niesie za sobą duże ryzyko. Wadliwy kod w pętli
może w krótkim czasie uszkodzić setki artykułów, dlatego najlepiej jest testować jego działanie w
swoim brudnopisie.

Figurka: Stan Lee - Excelsior!
Informacje na temat mojego bota można znaleźć na [tej stronie](/projekty/wikizeitbot/).
---
### Konkursy Fotograficzne Wikimedia Commons
## Co to jest Wikimedia Commons?
Wikimedia Commons są to zasoby multimedialne Wikipedii i innych projektów tzw. siostrzanych.
Mimo że znajdują się tam różne pliki, jednak głównymi zasobami w Wikimedia Commons są zdjęcia.
Wszystkie zdjęcia udostępnione na wolnych licencjach Creative Commons.
Wikimedia Commons jest to projektem wielojęzycznym, tzn. nie ma innych wersji językowych, jak w przypadku
Wikipedii. Jest jeden portal na stronie [commons.wikimedia.org](https://commons.wikimedia.org/),
natomiast można zmienić język interfejsu. Opisy zdjęć można dodawać w różnych językach. Więc szukając
Czegoś, w zasobach Commons, trzeba pamiętać o sprawdzenie nazw polskich, jak i angielskich.
## Co to są licencje Creative Commons?
Jest to zestaw licencji prawa autorskiego, które zmienia, w jaki sposób działa to prawo. Domyślnie
każde kreatywne dzieło człowieka, np. zdjęcie, filmy, artykuł na blogu, są objęte prawem autorskim.
Domyślnie oznacza to: "Wszystkie Prawa Zastrzeżone" (po angielsku "All Right Reserved") i nikt nie
może kopiować danego dzieła bez zgody autora. Nie jest wymagane opisanie danego dzieła w żaden sposób
np. poprzez dopisanie notki Copyright, prawo autorskie działa automatycznie.
Natomiast licencje Creative Commons, zmieniają zasady działania prawa autorskiego. Dając pewne prawa
do kopiowania danego dzieła. Prawa, o których decyduje autor dzieła.
Licencje te dają kilka klocków, które można łączyć kombinacje. Oto one:
* Attribution - uznanie autorstwa - BY
* Non-Derivative - bez utworów zależny - ND
* Non-Commercial - bez użytku komercyjnego - NC
* Share-Alike - na tych samych warunkach - SA
Każda licencje (z jednym wyjątkiem, o którym za chwilę) musi mieć człon BY (czyli uznanie autorstwa)
Oznacza to, że używając np. zdjęcia na licencji Creative Commons, trzeba podpisać, kto je zrobił.
Przykłady:
* BY - najbardziej liberalna, oznacza że dzieło można używać w dowolny sposób tylko trzeba podpisać
kto jest autorem.
* BY-NC-SA - oznacza że nie można użyć do celów komercyjnych a każda modyfikacja musi mieć taką samą
licencje.
* BY-SA - jest to licencja, której zazwyczaj używam, oznacza to samo co wyżej tylko można
wykorzystywać do celów komercyjnych.
## Creative Commons Zero
Jest to specjalna licencja, która oznacza, że dzieło jest w [Domenie
Publicznej](https://pl.wikipedia.org/wiki/Domena_publiczna). Czyli tak jakby nie miało żadnych praw
autorskich. Do domeny publicznej zazwyczaj przechodzą dzieła, których ochrona prawo autorska
wygasła. Zazwyczaj, ponieważ autor umarł dawno temu. W Polsce aktualnie jest to 70 lat. Przy czym
jest to trochę bardziej skomplikowane dla dzieł, które nie mają znanego autora.
## Historia licencji Creative Commons
Creative Commons zainicjował [Lawrence Lessig](https://pl.wikipedia.org/wiki/Lawrence_Lessig),
amerykański profesor prawa na Harvardzie. Idea licencji wzięła się prawdopodobnie z ruchu Otwartego
Oprogramowania, które z kolei było bardziej przystępną, dla korporacji, wersją Wolnego Oprogramowania.
Problem z Wolnym Oprogramowaniem był taki, że po angielsku Wolny to Free, co ma takie samo znaczenie
jak darmowy. Było to problematyczne z punktu widzenia biznesu, którego głównym celem jest zarabianie pieniędzy.
Wprowadzenie "marki" Open Source otwarło drzwi i rozprzestrzeniło idee wolności na cały świat.
Jeśli interesuje cię historia ruchu Open Source, która związana jest z Linuxem, polecam film dokumentalny:
[Revolution OS](https://en.wikipedia.org/wiki/Revolution_OS), dostępny w serwisie YouTube.
Dzisiaj mamy, otwartą wiedzę, otwartą naukę, otwarte dane. A wszystko to dzięki Creative Commons, które przeniosło
idee Open Source, dotyczącą programów komputerowych, na inne kreatywne dzieła oraz inną działalność człowieka.
Warto wspomnieć, że duży wpływ, na licencje Creative Commons, miał [Aaron
Swartz](https://pl.wikipedia.org/wiki/Aaron_Swartz). Aktywista, który zginął śmiercią
samobójczą. Przez wielu uważany za męczennika w obronie dostępu do wiedzy.
Historie Aarona można obejrzeć w filmie dokumentalnym: [The Internet's Own Boy: The Story of Aaron
Swartz](https://en.wikipedia.org/wiki/The_Internet%27s_Own_Boy).
## Licencje w Wikimedia Commons
Wróćmy do Wikipedia Commons. Jest to miejsce, gdzie można udostępnić, między innymi, swoje zdjęcia, które jednak
trzeba udostępnić na licencji Creative Commons. Istnieje jednak zastrzeżenie, że dzieła mogą być tylko na trzech
rodzajach licencji. Wszystkie nie są dozwolone. Są nimi:
* CC-BY - uznanie autorstwa
* CC-BY-SA - uznanie autorstwa, na tych samych warunkach
* CC-0 - domena publiczna
Wymóg ten jest podyktowany tym, że każdy musi mieć wolność modyfikacji danego działa, oraz musi mieć
możliwość używania do celów komercyjnych.
## Ochrona Wizerunku
Nie trzeba się obwiać, np. publikując zdjęcia jakieś osoby, ponieważ w Polsce istnieje prawo ochrony wizerunku.
Więc nawet jak zdjęcie ja na licencji CC-0 (bez praw autorskich) nie można sobie, od tak, użyć czyjegoś wizerunku,
np. na plakacie, czy w reklamie. Musi się uzyskać zgodę danej osoby.
Taka ochrona jest automatyczna, tak jak w przypadku prawa autorskiego. Ale można dodatkowo oznaczyć dane dzieło
specjalnym oznaczeniem (w projektach Wikimediowych nazywaną szablonem)
[Personality rights](https://commons.wikimedia.org/wiki/Template:Personality_rights).
## Dzieła nieobjęte prawem autorskim
Trzeba zaznaczyć, że niektóre twory człowieka nie spełniają warunków bycia kreatywnym dziełem. Różne kraje mają inne
wymagania w tej sprawie. Przykładem są proste logotypy, które oznaczone są jako niemające praw autorskich, bo są
to proste geometryczne kształty. Taką grafiką może być np. logo Google:

Ważne jest jednak aby pamiętać o tym, że mimo że loga nie mają ochrony prawno autorskiej, mogą mieć ochronę
jako [znak towarowy](https://pl.wikipedia.org/wiki/Znak_towarowy).
Więc tak jak w przypadku ochrony wizerunku, nie można sobie bez karnie używać tego typu grafik do własnych celów.
Przykładem szczególnej ochrony są logotypy Wikimedia Foundation (takie jak logo Wikipedii), które są chronione znakiem towarowym.

Wikimedia Foundation, author [Neolŭ](https://en.wikipedia.org/w/index.php?oldid=738322287); Domena Publiczna; [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Wikimedia_Foundation_logo_-_vertical.svg)
Użycie znaków towarowych Wikimedia Foundation zostało opisane na stronach:
* [Polityka znaków towarowych](https://foundation.wikimedia.org/wiki/Policy:Wikimedia_Foundation_Trademark_Policy/pl)
* [Identity guidelines](https://foundation.wikimedia.org/wiki/Legal:Visual_identity_guidelines)
Jakby ktoś pytał, użycie w artykule opisującym projekty Wikipedia jest dozwolone. Ale już np. użycie w celach komercyjnych,
np. użycie w celach promocji płatnych edycji (które realizuje WikiZEIT) nie jest dozwolone. Dlatego na stronie
[oferta](/oferta.md), gdy mam obrazek, który wyświetla się w mediach społecznościowych (po wklejeniu linka) mam grafikę wygenerowaną
przez AI.

ChatGPT; Domena Publiczna; [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Wikipedia_puzzle.png)
## Twory wygenerowane przez sztuczną inteligencję
Uznane zostało, że twory wygenerowane przez sztuczną inteligencję, tak jak wszystkie twory, nie
stworzone przez człowieka, np. zwierze, Nie posiadają praw autorskich.
Przykładem tworu, który prawdopodobnie był powodem uznania dzieł AI jako niemającego prawa autorskiego jest
historia [Małpiego Selfie](https://pl.wikipedia.org/wiki/Małpie_selfie).

Makak Naruto; Aparat Davida Slatera; Domena Publiczna; [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Macaca_nigra_self-portrait.jpg)
Zdjęcie wykonała Makak zwany Naruto, aparatem Davida Slatera. Sąd uznał, że dzieło jest w domenie publicznej, ponieważ nie
zostało wykonanie przez człowieka. Jeśli jesteś zainteresowany szczegółami historii, sprawdź artykuł w Wikipedii (link powyżej).
## Konkursy Fotograficzne
Po tym długim wstępie, o zasadach Wikimedia Commons, przejdzmy do istoty wpisu, czyli konkursów
fotograficznych w Wikimedia Commons:
### Wiki Lubi Zabytki
Jest to największy konkurs fotograficzny organizowany przez Wikimedia Foundation. Jeden z dwóch, w
których aktywny udział bierze Polska, dzięki wsparciu [Wikimedia
Polska](https://pl.wikimedia.org/wiki/Wiki_Lubi_Zabytki). **Wiki Lubi Zabytki** (międzynarodowa
nazwa: *Wiki Loves Monuments*) to konkurs fotograficzny, którego celem jest wizualne udokumentowanie
historycznego dziedzictwa materialnego. W Polsce konkurs organizowany jest tradycyjnie każdego roku
przez cały wrzesień. Do konkursu można zgłaszać fotografie [zabytków
nieruchomych](https://pl.wikipedia.org/wiki/Zabytek_nieruchomy), które znajdują się w rejestrach
[Narodowego Instytutu Dziedzictwa](https://pl.wikipedia.org/wiki/Narodowy_Instytut_Dziedzictwa).
Gdy konkursy, z wszystkich krajów się skończą (różne kraje organizują konkurs w różnych miesiącach
jesieni), następuje wyłonienie najlepszych zdjęć w konkursie międzynarodowym.
Moje zdjęcie wygrało IV miejsce w Polsce oraz III w konkursie międzynawowym w 2022 roku:

Jaszczórówka (Zakopane) nocą; CC-BY-SA 4.0; [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Jaszczurówka_at_Winter.jpg)
### Wiki Science Competition
Drugim konkursem fotograficznym, w którym bierze udział Polska, jest Wiki Science Competition. Jest
to konkurs organizowany co dwa lata. Organizowany w 2021, 2023 oraz 2025. Kolejna edycja
w 2027. Jego celem jest udokumentowanie świata nauki i przyrody.
Poniżej strony z wyróżnionymi zdjęciami w Polsce:
* [Wyniki konkursu z 2021 roku](https://pl.wikipedia.org/wiki/Wikipedia:Wiki_Science_Competition_2021/Wyniki/2021)
* [Wyniki konkursu z 2023 roku](https://pl.wikipedia.org/wiki/Wikipedia:Wiki_Science_Competition_2023/Wyniki/2023)
* [Wyniki konkursu z 2025 roku](https://pl.wikipedia.org/wiki/Wikipedia:Wiki_Science_Competition_2025/Wyniki)
Tak jak w przypadku Wiki Lubi Zabytki jest też etap międzynarodowy.
### Konkursy międzynarodowe
Oba powyższe konkursy organizowane są w dwóch etapach, lokalnym danego kraju, oraz międzynarodowym, gdzie wybrane są najlepsze
zdjęcia z całego świata. Oprócz tych wyżej wymienionych istnieją także konkursy, w których Polska nie bierze udziału.
#### Wiki Love Earth
Wiki Loves Earth (WLE) to międzynarodowy konkurs fotograficzny skupiający się na dokumentowaniu
naturalnego dziedzictwa naszej planety. W Polsce organizowany był tylko raz w 2015 roku pod nazwą [Wiki Lubi
Przyrodę](https://pl.wikipedia.org/wiki/Wikipedia:Wiki_Lubi_Przyrodę).
#### Wiki Love Folklor
Wiki Loves Folklore to międzynarodowy konkurs multimedialny odbywający się co roku od 1 lutego
do 31 marca. Jego celem jest udokumentowanie niematerialnego dziedzictwa kulturowego – tradycji,
obrzędów, tańców, strojów ludowych, rzemiosła oraz kuchni regionalnej z całego świata.
W odróżnieniu od Wiki Love Earth, Polacy mogą brać udział w Wiki Love Folklor, mimo że Polska nie
organizuje własnej edycji. Wystarczy [zgłosić zdjęcie bezpośrednio do etapu
międzynarodowego](https://commons.wikimedia.org/wiki/Commons:Wiki_Loves_Folklore_2026/pl).
#### Picture of the Year
[Picture of the Year](https://commons.wikimedia.org/wiki/Commons:Picture_of_the_Year) jest to
konkurs na najlepsze zdjęcie z całego roku, które trafiło do Commons. Jest to wyróżnienie, za które
nie przyznawane są nagrody.
#### Monthly Photo Challenge
Oprócz konkursów, w Commons, organizowane są wyzwania trwające cały miesiąc. Wybierane są dwa tematy, które można zgłaszać do wyzwania.
Tak jak w przypadku Picture of the Year, za wygraną w wyzwaniu, nie są przyznawane żadne nagrody.
Więcej o wyzwaniach na stronie Wikimedia Commons: [Foto wyzwanie](https://commons.wikimedia.org/wiki/Commons:Photo_challenge/pl).
## Podsumowanie
Głównym celem konkursów jest wzbogacanie zasobów Commons o darmowe, wysokiej jakości pliki
multimedialne, które mogą, chociaż nie muszą, ilustrować artykuły w Wikipedii. Jednocześnie projekty
te aktywizują globalną społeczność fotografów, zachęcając ich do dzielenia się swoją twórczością na
wolnych licencjach.
Podobnie jak w innych tego typu konkursach, organizowanych na całym świecie, tutaj również na
zwycięzców czekają realne nagrody finansowe i rzeczowe. Dla wielu autorów największą motywacją
pozostaje jednak prestiż i świadomość, że ich zdjęcia będą codziennie ilustrować wiedzę dla milionów
ludzi na całym świecie.
---
### Płatna Edycja Wikipedii w Polsce
W dzisiejszym świecie Wikipedia to coś więcej niż encyklopedia – to cyfrowy fundament zaufania. Dla
firmy lub osoby publicznej obecność w tym serwisie jest ostatecznym potwierdzeniem statusu i
autorytetu. Należy jednak pamiętać, że granica między rzetelną informacją a zakazaną promocją jest
niezwykle cienka, a jej przekroczenie kończy się natychmiastowym usunięciem treści.
## Czy płatna edycja Wikipedii jest zgodna z zasadami?
Wiele osób zastanawia się, czy płacenie za edycję nie łamie zasad Wikipedii. Krótka odpowiedź brzmi:
**jest to ok, pod warunkiem pełnej transparentności.** Fundacja Wikimedia wymaga, aby każda płatna
edycja była oznaczona deklaracją **Konfliktu Interesów
([WP:KI](https://pl.wikipedia.org/wiki/WP:KI))**. Społeczność Polskiej Wikipedii nie ma
wypracowanych własnych zasad dotyczących płatnej edycji, więc funkcjonują zasady ogólne.
Zobacz: [Paid Editing Disclosure](https://wikimediafoundation.org/story/paid-editing-disclosure/)
oraz [Terms of Use](https://foundation.wikimedia.org/wiki/Policy:Terms_of_Use/pl).
Warto jednak wiedzieć, że większość najbardziej aktywnych i zaangażowanych redaktorów polskiej
Wikipedii podchodzi do płatnych zleceń z dużą niechęcią i rzadko podejmuje się takiej współpracy,
preferując wolontariat i dbanie o czystość merytoryczną haseł.
## Widoczność w Google oraz AI
Wikipedia to "paliwo" dla algorytmów. Jej znaczenie wykracza poza samą witrynę:
* **Graf wiedzy Google (Google Knowledge Graph):** Wpis w Wikipedii niemal gwarantuje pojawienie się
Panelu Wiedzy po prawej stronie wyników wyszukiwania.
* **Sztuczna Inteligencja:** Modele takie jak ChatGPT czy Google Gemini traktują Wikipedię jako
jedno z głównych źródeł prawdy przy generowaniu odpowiedzi.
* **Pełny panel wiedzy:** Aby uzyskać rozbudowany profil ze zdjęciami i powiązanymi artykułami, sama
**encja** w Grafie Wiedzy nie wystarcza, wymagana jest także duża widoczność w mediach oraz
silna marka osobista.
## Mit "czyszczenia wizerunku" vs. rzeczywistość
Wikipedia nie służy do PR-u. Jeśli firma ma na koncie głośny skandal opisany w rzetelnych źródłach,
próba usunięcia tych informacji przez płatnego edytora jest skazana na porażkę. Zgodnie z zasadą
**Neutralnego Punktu Widzenia ([WP:NPOV](https://pl.wikipedia.org/wiki/WP:NPOV))**, artykuł musi
przedstawiać pełen obraz – zarówno sukcesy, jak i kontrowersje.
## Kryterium Encyklopedyczności: Największa bariera wejścia
To najważniejszy punkt: **jeśli potrzebujesz Wikipedii, aby stać się zauważalnym w mediach, to
prawdopodobnie nie nadajesz się do Wikipedii.** Encyklopedia dokumentuje istniejący stan rzeczy,
a nie go kreuje.
* Firmy i osoby naprawdę encyklopedyczne często nie potrzebują tej promocji.
* Wpis ma być koroną wieńczącą wizerunek, a nie fundamentem kampanii marketingowej.
* Weryfikacja jest bezlitosna – brak wystarczającego "szumu" w mediach oznacza usunięcie artykułu.
## Źródła, czyli fundament każdego wpisu
W Wikipedii nie liczy się to, co wiesz, ale to, co możesz udowodnić. Jedna z głównych zasad to
weryfikowalność czyli [WP:WER](https://pl.wikipedia.org/wiki/WP:WER)
* **Akceptowalne źródła:** Ogólnopolskie media informacyjne, książki, recenzowane czasopisma,
artykuły naukowe.
* **Źródła odrzucane:** Artykuły sponsorowane, komunikaty prasowe, własna strona WWW, media
społecznościowe oraz wszelkie źródła zależne od podmiotu.
* **Ważne:** Edycje bez przypisów mogą zostać usunięte bez podania przyczyny. Obowiązuje zakaz
tzw. **twórczości własnej ([WP:NOR](https://pl.wikipedia.org/wiki/WP:NOR))** – nie piszemy "z
głowy", nawet jeśli jesteśmy ekspertami.
## Prawa autorskie
Kopiowanie treści to najprostsza droga do blokady. Nawet jeśli jesteś autorem tekstu na swojej
stronie firmowej, **nie możesz go wkleić do Wikipedii**. Wszystkie treści tam zawarte muszą być
dostępne na wolnej licencji [Creative
Commons](https://pl.wikipedia.org/wiki/Creative_Commons). Proces legalizacji treści przez system
OTRS/VRTS jest skomplikowany, dlatego najlepiej pisać artykuły od zera, własnymi słowami. Ale
pamiętać trzeba o źródłach. Bazujemy na informacjach, ale ich nie kopiujemy. Chyba że jest to mały
fragment, udostępniony na zasadach [cytatu](https://pl.wikipedia.org/wiki/Cytat).
## Treść generowana przez AI a Wikipedia – zasady i ryzyka
W dobie popularności ChatGPT i innych modeli LLM, pokusa generowania haseł przez AI (Artificial
Intelligence) jest duża. Jednak polska Wikipedia podchodzi do tego bardzo restrykcyjnie (zgodnie z
zaleceniami społeczności):
* **Pełna odpowiedzialność edytora:** To Ty (człowiek) odpowiadasz za każde słowo wprowadzone do
encyklopedii. Jeśli AI "zmyśli" fakt lub źródło (tzw. halucynacje), konsekwencje ponosi autor
wpisu, co często kończy się blokadą konta.
* **Weryfikacja źródeł:** Modele AI mają tendencję do tworzenia nieistniejących przypisów. Każda
informacja wygenerowana przez SI musi zostać ręcznie sprawdzona w rzeczywistych źródłach.
* **Problemy ze stylem i redundancją:** Teksty z AI są często "puste" informacyjnie, zawierają
dużo zbędnych przymiotników i ogólników, co jest sprzeczne z encyklopedycznym stylem.
* **Prawa autorskie i unikalność:** Wikipedia wymaga treści unikalnych. Bezmyślne kopiowanie
odpowiedzi z AI może naruszać zasady dotyczące jakości i być traktowane jako spam.
**Wniosek:** AI może być pomocnikiem w tłumaczeniu tekstów lub poprawianiu gramatyki, ale nigdy nie
powinno być jedynym autorem artykułu. Płatna edycja oparta wyłącznie na "copy-paste" z ChataGPT to
najkrótsza droga do usunięcia wpisu.
## Jak dodać firmę do Wikipedii? – proces krok po kroku
1. **Analiza źródeł:** Sprawdź, czy o firmie pisały niezależne media (nie lokalne, nie branżowe).
2. **Przygotowanie szkicu:** Stwórz tekst w brudnopisie, dbając o encyklopedyczny styl.
3. **Deklaracja [WP:KI](https://pl.wikipedia.org/wiki/WP:KI):** Poinformuj na swojej stronie
użytkownika o powiązaniach z firmą.
4. **Publikacja i weryfikacja:** Poproś swojego przewodnika o sprawdzenie i publikację, jeśli masz
konto od niedawna. Jeśli jesteś w Wikipedii już od [jakiegoś
czasu](https://pl.wikipedia.org/wiki/WP:AC), możesz przenieść artykuł do przestrzeni głównej
sam(a). Prośbę o sprawdzenie można także zgłosić na stronie
[Wikipedia:Pytania_nowicjuszy](https://pl.wikipedia.org/wiki/Wikipedia:Pytania_nowicjuszy).
## Jak stworzyć biografię osoby (np. CEO lub eksperta)?
Wymagania dla biografii osób żyjących (BIO) są jeszcze surowsze. Należy wykazać, że osoba ta wywarła
istotny, trwały wpływ na swoją dziedzinę. Same występy w śniadaniówkach czy posiadanie dużej firmy
to za mało – liczą się nagrody, publikacje i szerokie uznanie środowiska.
## Najczęstsze błędy i "pocałunek śmierci" dla artykułu
Unikaj tych błędów, jeśli nie chcesz, by Twój wpis zniknął w kilka minut:
* **Język marketingowy:** [Zwroty zwodnicze](https://pl.wikipedia.org/wiki/WP:WZ), typu "lider
branży", "najlepszy produkt", "eksperci uważają".
* **Błędy techniczne:** Błędne formatowanie, np. pogrubienia zamiast nagłówków.
* **Powtórzenia:** Każda informacja powinna być napisana tylko raz. Wikipedia to nie jest blog, czy
artykuł w czasopiśmie, gdzie trzeba przypominać co było wcześniej w artykule.
* **Brak deklaracji [WP:KI](https://pl.wikipedia.org/wiki/WP:KI):** Ukrywanie faktu otrzymania
wynagrodzenia za edycję.
* **Linki w treści** Linki mogą się znajdować tylko w sekcji linki zewnętrzne, jako przypisu oraz w
infoboksie.
## Reklama w Wikipedii – dlaczego to podejście jest ryzykowne?
Wielu przedsiębiorców błędnie zakłada, że skoro Wikipedia jest popularna, to stanowi idealne miejsce
na darmową promocję. Encyklopedia ta to nie jest platforma marketingowa, czy panorama firm. Dlatego
pod żadnym pozorem nie może służyć jako tablica ogłoszeniowa czy nośnik reklamowy. Próba uprawiania
działań typu **marketing w Wikipedii** spotyka się z natychmiastową i bardzo ostrą reakcją
społeczności.
* **Alergia na marketing:** Doświadczeni Wikipedyści są niezwykle wyczuleni na język korzyści.
Wszelkie przymiotniki wartościujące („nowoczesny”, „innowacyjny”, „unikalny”) działają na nich
jak płachta na byka i często skutkują nie tylko usunięciem treści, ale i zablokowaniem domeny.
* **Problem z obiektywizmem:** Marketing z natury dąży do podkreślania zalet, podczas gdy
Wikipedia wymaga suchego, encyklopedycznego zapisu faktów. Jeśli Twoim celem jest budowanie
pozytywnego wizerunku poprzez ukrywanie wad produktu, Wikipedia nie jest dla Ciebie.
* **Link building:** Próby dodawania linków do strony firmowej jako „źródeł” w niepowiązanych
tematycznie artykułach są traktowane jako spam i szybko trafiają na czarną listę.
Właśnie dlatego, aby uniknąć oskarżeń o spam i agresywny marketing, warto zlecić pisanie artykułu
profesjonalistom. Osoba z doświadczeniem wie, jak przekazać istotne fakty o firmie w sposób, który
spełnia standardy encyklopedyczne i nie budzi niechęci społeczności redaktorów.
## Dlaczego warto (lub nie warto) wynająć doświadczonego redaktora?
Samodzielna edycja często kończy się tzw. „spaloną ziemią” – zrażeniem administratorów i
zablokowaniem tematu na długi czas. Warto zastanowić się nad bilansem zysków i strat. Nauka zasad
Wikipedii to proces czasochłonny i żmudny. Jeśli Twoim celem jest stworzenie tylko jednego hasła
dla siebie lub swojej firmy, próba samodzielnego opanowania skomplikowanych reguł i technicznych
aspektów formatowania może okazać się zwyczajnie nieopłacalna. W takim przypadku znacznie prościej
i bezpieczniej jest zlecić edycję specjaliście.
Sytuacja zmienia się jednak, gdy pracujesz w agencji SEO, PR lub zajmujesz się budowaniem marek
osobistych (personal branding) i planujesz robić to zawodowo. Wówczas opanowanie zasad poprawnej
edycji staje się cenną kompetencją rynkową. Wiedza na ten temat jest co prawda publicznie dostępna,
ale mocno rozproszona po licznych stronach pomocy samej Wikipedii. Można również korzystać z
materiałów wideo, np. na [kanale YouTube stowarzyszenia Wikimedia
Polska](https://www.youtube.com/@wikimediapolska), jednak samodzielne składanie tych informacji w
całość zajmuje mnóstwo czasu.
Dla osób, które chcą pozyskać konkretną wiedzę w skondensowanej formie, idealnym rozwiązaniem jest
udział w profesjonalnym szkoleniu. Przykładem jest kurs organizowany przez WikiZEIT o nazwie
„[Wikipedia + SEO i nie tylko](/oferta.md)”, który w praktyczny sposób uczy, jak tworzyć trwałe i wartościowe
wpisy, unikając przy tym błędów prowadzących do ich usuwania.
Warto przy tym zaznaczyć istotne rozróżnienie: stowarzyszenie **Wikimedia Polska** również oferuje
darmowe szkolenia i warsztaty, jednak mają one charakter misyjny i są dedykowane konkretnym grupom,
takim jak **nauczyciele, bibliotekarze, uczniowie oraz studenci**. Ich celem jest szerzenie idei
wolnej wiedzy w edukacji i nauce. W przypadku firm, agencji PR, specjalistów SEO czy osób dbających
o wizerunek komercyjny, które muszą poruszać się w tematyce płatnych edycji, jedyną dedykowaną opcją
na polskim rynku pozostaje szkolenie **WikiZEIT**. Pozwala ono połączyć surowe zasady encyklopedii z
potrzebami nowoczesnego marketingu i budowania marki osobistej.
Doświadczony redaktor (lub przeszkolony pracownik):
* Potrafi obiektywnie ocenić szanse na przetrwanie wpisu przed rozpoczęciem prac.
* Zna techniczny język formatowania oraz biegle posługuje się mechanizmami społeczności.
* Wprowadza treści zgodnie z oficjalnymi procedurami (np. deklaracja
[WP:KI](https://pl.wikipedia.org/wiki/WP:KI)), co minimalizuje ryzyko szybkiego usunięcia
artykułu.
* Potrafi odpowiednio dobrać źródła, które zostaną zaakceptowane przez innych redaktorów.
## Kto zajmuje się płatną edycją Wikipedii w Polsce?
Na polskim rynku istnieje kilka głównych podmiotów i ścieżek:
* **WikiZEIT (Jakub T. Jankiewicz):** Specjalistyczne podejście, gdzie nacisk kładzie się na
kompletność wpisu i transparentność.
* **Soluma Interactive:** Agencja marketingowa oferująca pakiety edycyjne, w tym audyt i pisanie
haseł.
* **Green-fields:** Firma zajmująca się wizerunkiem, która w ofercie ma również Wikipedię.
* **Freelancerzy (UseMe/LinkedIn):** Można tam znaleźć osoby deklarujące pomoc, jednak ich
doświadczenie i znajomość aktualnych zasad bywają bardzo zróżnicowane.
## Ile kosztuje wpis w Wikipedii? Cennik i modele rozliczeń
Koszty zależą od skomplikowania tematu i renomy wykonawcy:
* **Modele godzinowe:** Przykładowo w **WikiZEIT** wstępna analiza jest darmowa, a koszt edycji to
obecnie do **300 zł za godzinę**. Średni czas przygotowania solidnego artykułu to około dwie
godziny pracy redaktora.
* **Modele pakietowe:** W **Soluma Interactive** sam audyt to koszt rzędu **440 zł**. Napisanie
artykułu kosztuje około **1000 zł**, przy czym dodatkowe elementy, jak zdjęcia czy infoboxy,
często są wyceniane jako osobne pozycje.
* **Ważne:** Żaden rzetelny redaktor nie zagwarantuje 100% pewności, że wpis pozostanie w
serwisie na zawsze, ponieważ ostateczna decyzja należy do społeczności administratorów.
## Jeśli nie Wikipedia to co?
Dla podmiotów, które nie spełniają surowych norm encyklopedyczności, idealnym rozwiązaniem są
projekty siostrzane:
* **Wikimedia Commons:** Tu możesz dodać zdjęcia firmowe, logo czy portrety CEO. Wymagana jest
zgoda fotografa i wolna licencja.
* **Wikidane:** To baza danych łącząca wszystkie projekty. Jest kluczowa dla Google i AI.
Zasady są tu mniej restrykcyjne niż w samej Wikipedii.
* **Synergia:** WikiZEIT oferuje łączenie tych usług – dodanie zdjęcia do Commons, wpisu do
Wikidanych i połączenie ich z Wikipedią buduje spójny „cyfrowy ślad” marki.
## Podsumowanie: Wikipedia to maraton, nie sprint
Obecność w Wikipedii to nie jednorazowa usługa marketingowa, ale proces dokumentowania realnych
osiągnięć. Skuteczna płatna edycja wymaga cierpliwości, doskonałych źródeł i pokory wobec zasad
społeczności. To prestiż, który stanowi ukoronowanie osiągnięć, a nie drogę do ich zdobycia.
---
### Czy Wikipedia jest płatna? Wikimedia Enterprise i SEO
## Czy Wikipedia jest płatna?
Dla normalnego użytkownika Wikipedia jest i zawsze będzie darmowa. Nie zawiera i raczej nie będzie
zawierać także także reklam. Jednak firmy takie jak Google czy Meta (dawny Facebook), które czerpią
z Wiki gigantyczne zyski, zaczęły płacić za profesjonalny dostęp do jej zasobów. Dane z Wikipedii w
dobie AI są na wagę złota.
Sprawdźmy, jak działa ten mechanizm.
## Co to jest Wikimedia Enterprise?
To komercyjna usługa API uruchomiona w 2021 roku. Skierowana jest do podmiotów operujących na
ogromną skalę. Firmy takie jak Google czy Microsoft nie muszą już
„[scrapować](https://en.wikipedia.org/wiki/Web_scraping)” stron. W zamian za opłaty otrzymują:
* **Dedykowany strumień:** Dane w czasie rzeczywistym.
* **Gwarancję SLA (Service Level Agreement):** Pewność dostępności systemów.
* **Format JSON:** Dane gotowe do użycia przez maszyny.
Co ciekawe w ramach Wikimedia Enterprise fundacja zapewnia także darmowy dostęp do API, które oferuje:
* 50,000 zapytań na miesiąc.
* 30 zapytań na miesiąc o kopie (zrzut) bazy (ang. Snapshot).
Limity te zostały zwiększone 2 czerwca 2026. Więcej na
[stronie projektu](https://enterprise.wikimedia.com/blog/enhanced-free-api/).
## Czy Fundacja Wikimedia zarabia na Wikipedii?
Tak, usługa **Wikimedia Enterprise** jest płatna. W roku fiskalnym 2023–2024 wygenerowała **3,4 mln
dolarów przychodu**.
* **Klienci:** Płacą m.in. Google, Meta i Perplexity.
* **Niezależność:** Przychody z Enterprise to ok. 2% budżetu Fundacji. Limit ustalono na 30%, aby
zachować niezależność od korporacji.
* **Misja:** Pieniądze wspierają serwery i edytorów.
## Kto płaci za Polską Wikipedię?
Polska Wikipedia utrzymuje się głównie z dobrowolnych wpłat. Kluczową rolę odgrywa tu
[Stowarzyszenie Wikimedia Polska](https://wikimedia.pl/), które posiada status Organizacji
Pożytku Publicznego (OPP).
Dzięki temu każdy podatnik w Polsce może przekazać **1,5% swojego podatku dochodowego** na wsparcie
wolnej wiedzy.
* **Finanse:** W budżecie Stowarzyszenia na 2024 rok wpływy z 1,5% zaplanowano na **1,4 mln zł**.
* **Udział:** Stanowi to niemal **połowę (ok. 45-50%)** całkowitych przychodów organizacji.
* **Cel:** Środki te finansują serwery, konkursy dla edytorów (np. Wiki Lubi Zabytki) oraz
szkolenia.
To prosta metoda wsparcia, która nie kosztuje Cię ani grosza, a realnie buduje polskie zasoby Wiki.
[Przekaż 1.5% podatku na Wikipedię już dziś](https://opp.wikimedia.pl/).
## Perspektywa SEO: Wikipedia jako fundament
Dla specjalistów SEO Enterprise to jasny sygnał:
1. **[Knowledge Graph](/tools/graf-wiedzy/):** Google jeszcze szybciej integruje dane w wynikach wyszukiwania.
2. **Paliwo dla AI:** Modele LLM (jak GPT-4) karmią się tymi danymi. Jakość treści na Wiki wpływa na
to, co AI mówi o Twojej marce.
3. **Szybkość:** Zmiany w artykułach trafiają do wyszukiwarek niemal natychmiast (real-time).
4. **[Autorytet (E-E-A-T)](/blog/widoczonosc-marki-osobistej-w-ai/#co-to-jest-e-e-a-t%3F):** Wikipedia to główny punkt weryfikacji powiązań między bytami w sieci.
## Szybkość, która zaskakuje: Google vs EK
Ciekawostką jest niesamowita szybkość, z jaką Google reaguje na zmiany. Obserwacje pokazują, że nowe
strony są indeksowane w ciągu zaledwie kilku minut.
Dzieje się to tak szybko, że nawet gdy artykuł zostaje niemal natychmiast skasowany przez
administratorów (tzw. EK – ekspresowe kasowanie), Google często zdąży już pobrać jego treść.
To pokazuje różnicę między dawnym „czekaniem na bota” a obecnym strumieniem danych live. Dla SEO to
dowód, że Google traktuje ekosystem Wiki jako priorytetowe źródło informacji, któremu ufa
bezgranicznie.
## Nie tylko Wikipedia, czyli projekty siostrzane
Wikimedia Enterprise to nie tylko teksty z Wikipedii. Usługa agreguje dane z całego ekosystemu, co
ma kluczowe znaczenie dla nowoczesnego internetu:
* **[Wikidane (Wikidata)](/blog/czym-sa-wikidane.md):** To serce usługi. Dostarcza ponad 120 mln ustrukturyzowanych obiektów. To
stąd Google czerpie fakty (daty, liczby, powiązania) do paneli wiedzy (Knowledge Panels).
* **Wikimedia Commons:** API dostarcza bezpośrednie linki do mediów oraz precyzyjne dane o
licencjach. Dzięki temu giganci mogą legalnie wyświetlać zdjęcia przy zachowaniu praw autorskich
autorów.
* **Inne projekty:** Usługa obejmuje też Wikisłownik czy Wikitravel, tworząc kompletny obraz wiedzy
dostępny w jednym, szybkim strumieniu danych.
Dla SEO oznacza to, że optymalizacja pod graf wiedzy wymaga dziś dbania nie tylko o treść artykułu,
ale też o dane strukturalne w Wikidanych.
## Wikidane: Real-time dla Grafu Wiedzy
Powszechnie uważa się, że na zmiany w Grafie Wiedzy (ten boks po prawej w Google) czeka się
miesiącami. To prawda w przypadku tradycyjnych metod, ale Wikimedia Enterprise zmienia zasady gry.
Usługa udostępnia **Wikidane w czasie rzeczywistym** (API Realtime). Oznacza to, że każda edycja
strukturalna trafia do gigantów IT w milisekundach.
Dlaczego warto dbać o Wikidane już teraz?
* **Paliwo dla AI:** Modele językowe nie czytają tylko tekstu – one analizują relacje. Wikidane to
dla nich najczystsza forma wiedzy.
* **Skracanie kolejek:** Posiadanie ustrukturyzowanego wpisu w Wikidanych to najszybsza droga do
„zrozumienia” Twojej marki przez algorytmy Google.
* **Większy zasięg:** Dane z Wikidanych zasilają nie tylko Google, ale też asystentów głosowych
(Siri, Alexa) i tysiące aplikacji zewnętrznych.
Nawet jeśli Google potrzebuje czasu na weryfikację i wyświetlenie danych w Grafie Wiedzy, dzięki
Enterprise dostaje je natychmiast. To fundament Twojego E-E-A-T.
## Identyfikatory: Klucz do Twojego autorytetu
W Wikidanych istnieje sekcja „Identyfikatory”. To tam znajdują się linki do profili na LinkedIn,
Twitterze, bazach naukowych czy branżowych.
Dla Google to najważniejszy drogowskaz:
* **Łączenie kropek:** Enterprise przesyła te linki jako twarde dowody, że „Twoja Marka” na LinkedIn
to ten sam podmiot, co w Wikipedii.
* **Budowa E-E-A-T:** To najskuteczniejszy sposób na potwierdzenie swojej wiarygodności w oczach
algorytmu.
Dbanie o te powiązania w Wikidanych to obecnie jedna z najbardziej niedocenianych strategii SEO
technicznego.
## Pro TIP: Łącz dane z Schema.org
Pamiętaj, że dane z Wiki najlepiej działają w parze z Twoją stroną. Używając właściwości `sameAs` w
kodzie Schema.org, możesz wprost wskazać Google swój profil w Wikidanych. Więcej o tym przeczytasz
wkrótce w artykule:
[„Dane strukturalne Schema.org – przewodnik dla początkujących”](/blog/dane-strukturalne-schema-org.md).
## Strategiczny link w stopce
Mało kto to robi, a warto: dodaj link do swojego wpisu w Wikidanych w stopce strony. W połączeniu z
danymi strukturalnymi tworzy to „cyfrowy dowód tożsamości”. Pomagasz Google szybciej i pewniej
połączyć Twoją witrynę z oficjalną encją w Grafie Wiedzy.
## Podsumowanie
Wikimedia Enterprise to uczciwy układ. Giganci budujący biznesy na pracy wolontariuszy w końcu płacą
za infrastrukturę. Dla SEO to dowód, że Wikipedia oraz Wikidane pozostają „kręgosłupem” internetu.
---
Źródła użyte w artykule:
* [Oficjalna strona Wikimedia Enterprise](https://enterprise.wikimedia.com/)
* [Raport finansowy Fundacji (WMF)](https://diff.wikimedia.org/2025/11/24/wikimedia-enterprise-financial-report-fiscal-year-2024-2025/)
* [News: Giganci AI płacą za dane](https://itreseller.pl/giganci-ai-zaplaca-za-wiedze-wikimedia-foundation-oglasza-umowy-z-perplexity-microsoftem-i-meta/)
* [Wikidata APIs from Wikimedia Enterprise: Connect to the World’s Knowledge Graph](https://enterprise.wikimedia.com/blog/wikidata-api-endpoints-wikimedia-enterprise/)
---
### Baby Globe: czyli nowa maskotka Wikipedii
Z okazji 25-lecia Wikipedii powstała nowa maskotka o nazwie
[„Baby Globe”](https://wikimediafoundation.org/wikipedia25/wikipedia-mascot/).

Wikimedia Foundation staff and contractors; [CC BY-SA 4.0](https://creativecommons.org/licenses/by-sa/4.0); źródło [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Neutral_Baby_Globe.gif)
## Jak powstała nowa maskotka Wikipedii?
Autorem pomysłu ikony jest Jonathan Ferreira, w projektach Wikimedów znany jako
[BaduFerreira](https://en.wikipedia.org/wiki/User:BaduFerreira). Pierwotnie maskotka powstała jako szkic
wykonany w pociągu. Następnie, pomysł Jonathana, został rozwinięty przez pracowników fundacji Wikimedia. Tak powstała nowa maskotka Wikipedii.
Szczegóły powstania maskotki można poznać w [wywiadzie z Jonathanem w portalu Diff fundacji
Wikimedia](https://diff.wikimedia.org/2026/01/15/meet-the-wikimedian-whose-casual-sketch-inspired-wikipedias-25th-birthday-mascot/).
## Maskotka Wikipedii jako pluszak
Powstała także wersja maskotki, którą można przytulać. Dostępna w
[przedsprzedaży](https://www.makeship.com/products/baby-globe-plushie) (wysyłka w lipcu 2026).

Designed and produced by Makeship with the Wikimedia Foundation